MODELLE KRITISCH BEURTEILEN · FRAGE 8 VON 12
Warum sind Modelle nur Vereinfachungen der Wirklichkeit?
Ein Modell ist keine Kopie der Realität. Es wählt bestimmte Merkmale, Beziehungen und Annahmen aus, damit eine konkrete Frage überhaupt analysierbar wird. Diese Reduktion ist nicht bloß ein Mangel: Sie macht Modellierung erst möglich. Kritisch wird es dort, wo die vereinfachte Darstellung mit der Wirklichkeit selbst verwechselt oder ihre Gültigkeit über den geprüften Zweck hinaus ausgedehnt wird.
Kurzantwort: Modelle sind nützlich, weil sie Komplexität reduzieren. Sie berücksichtigen bestimmte Aspekte der Wirklichkeit und lassen andere weg. Deshalb muss ein Modell nicht vollständig sein, um hilfreich zu sein. Entscheidend ist vielmehr, ob seine Annahmen, Daten, Zielvariable und Validierung für die konkrete Fragestellung angemessen sind. Ein guter Fit, eine hohe Vorhersagegenauigkeit oder viele Nachkommastellen verwandeln ein Modell nicht in die Wirklichkeit selbst.
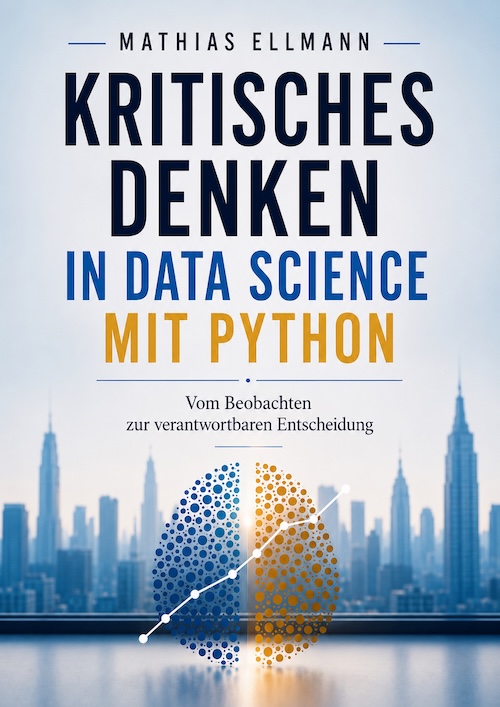
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Kritisches Denken in Data Science mit Python
Vom Beobachten zur verantwortbaren Entscheidung
Primäre Buchgrundlage: Kapitel 24 und 25 über Modelle und Vereinfachung, ergänzt durch Kapitel 26 zur Zielvariable und Kapitel 27 zur Prüfung von Generalisierung.
Ein Modell hebt etwas hervor – und lässt anderes weg
Buchaussage Das Buch definiert ein Modell als vereinfachte Darstellung eines Ausschnitts der Wirklichkeit. Modelle konzentrieren sich auf bestimmte Beziehungen oder Merkmale und blenden andere Aspekte aus. Gerade dadurch werden komplexe Situationen analysierbar.
Ein Navigationsmodell benötigt beispielsweise Straßen, Verbindungen und Entfernungen. Es benötigt für seine Routingaufgabe nicht jede Person, jedes Möbelstück und jede aktuelle Unterhaltung in den dargestellten Gebäuden. Vollständigkeit wäre für diesen Zweck kein Vorteil.
Einordnung Vereinfachung ist deshalb nicht automatisch ein Modellfehler. Die kritische Frage lautet vielmehr: Wurden genau diejenigen Eigenschaften vereinfacht oder ausgelassen, die für den vorgesehenen Zweck vertretbar ausgelassen werden können?
Wissenschaftliche Modelle können auf unterschiedliche Weise repräsentieren
Wissenschaftstheoretischer Kontext Die Stanford Encyclopedia of Philosophy beschreibt eine große Vielfalt wissenschaftlicher Modelltypen – darunter idealisierte, mathematische, explorative und repräsentationale Modelle. Viele Modelle repräsentieren ausgewählte Teile oder Aspekte eines Zielsystems. Stanford Encyclopedia: Models in Science
Idealisation kann dabei sogar bewusst Eigenschaften vereinfachen oder verzerren, um einen Zusammenhang untersuchbar zu machen. Ein klassisches Beispiel wäre ein physikalisches Modell mit reibungsfreier Fläche – obwohl reale Oberflächen nicht vollkommen reibungsfrei sind.
Quellengrenze Daraus folgt nicht, dass alle wissenschaftlichen Modelle nach demselben Schema funktionieren. Die externe Quelle dient hier ausschließlich dazu, die allgemeine Rolle von Auswahl, Idealisation und Repräsentation einzuordnen.
Abstraktion ist eine Voraussetzung für Analyse
Buchaussage Kapitel 25 betont, dass die Wirklichkeit mehr Einflussgrößen enthält, als ein praktisches Modell vollständig berücksichtigen kann. Für den Umsatz eines Unternehmens könnten gleichzeitig Preise, Wettbewerb, Produktqualität, Konjunktur, Kundenzufriedenheit, Saison und zahlreiche weitere Faktoren relevant sein.
Ein Modell muss deshalb auswählen. Diese Auswahl erzeugt eine überschaubare Struktur, in der Beziehungen beschrieben, Hypothesen geprüft oder Vorhersagen erzeugt werden können.
Einordnung Kritische Analyse verlangt damit zwei Fragen gleichzeitig: Was gewinnt das Modell durch seine Abstraktion? und welche relevanten Phänomene können durch dieselbe Abstraktion verloren gehen? Erst beide Fragen zusammen beschreiben die Leistung eines Modells angemessen.
Die Vereinfachung beginnt schon vor dem Modell
Buchaussage Das Buch macht deutlich, dass bereits ein Datensatz eine reduzierte Beschreibung darstellt. Eine reale Person besitzt Erfahrungen, Beziehungen, Ziele und Lebensumstände; ein Datensatz enthält vielleicht nur Alter, Einkommen, Wohnort und Kaufhistorie.
Das Modell arbeitet somit nicht unmittelbar mit einer Person, einem Unternehmen oder einem Markt. Es arbeitet mit einer bereits ausgewählten und operationalisierten Datenrepräsentation dieses Gegenstands.
Doppelte Reduktion Es lohnt sich deshalb, zwei Ebenen auseinanderzuhalten: Welche Wirklichkeitsaspekte wurden überhaupt zu Daten? und welche dieser Daten verwendet anschließend das Modell? Ein technisch anspruchsvolles Modell erzeugt jedoch keine nachträgliche Direktbeobachtung einer Größe, die nicht erhoben wurde. Es kann aus vorhandenen Merkmalen unter zusätzlichen Annahmen auf nicht direkt beobachtete Größen schließen oder diese schätzen. Eine solche Inferenz bleibt von den beobachteten Daten und den Modellannahmen abhängig.
Von der Wirklichkeit zur Entscheidung liegen mehrere Übersetzungsschritte
Buchaussage Kapitel 25 beschreibt den Weg als mehrstufige Folge: Wirklichkeit, Beobachtung, Messung, Datensatz, Modell und schließlich Vorhersage oder Entscheidung. Auf jeder Stufe kann Information verloren gehen; zugleich kommen neue Annahmen hinzu.
Eine Temperaturmessung benötigt beispielsweise ein Messgerät und eine Definition des Messpunkts. Ein Datensatz benötigt eine Auswahl der gespeicherten Messungen. Ein Modell benötigt wiederum Annahmen darüber, welche Variablen miteinander in Beziehung gesetzt werden sollen.
Einordnung Je weiter eine Handlungsempfehlung von der ursprünglichen Beobachtung entfernt ist, desto wichtiger wird deshalb die Rückverfolgbarkeit der Zwischenschritte. Eine Modellvorhersage sollte nicht so präsentiert werden, als wäre sie unmittelbar beobachtete Realität.
Ein Modell kann für einen Zweck gut und für einen anderen ungeeignet sein
Buchaussage Das Buch verschiebt die Leitfrage von „Ist das Modell vollständig?“ zu „Ist das Modell für seinen Zweck ausreichend?“. Ein Modell muss nicht sämtliche Eigenschaften seines Gegenstands enthalten, wenn diese für die konkrete Aufgabe keine relevante Rolle spielen.
Repräsentationskontext Die aktuelle SEP-Darstellung wissenschaftlicher Repräsentation diskutiert unter anderem Zwecke, Ziele, Nutzerintentionen und kontextabhängige Genauigkeitsstandards als relevante Aspekte wissenschaftlicher Repräsentation. Stanford Encyclopedia: Scientific Representation
Präzisionsgrenze Zweckmäßigkeit bedeutet nicht Wahrheit. Ein Modell kann für eine begrenzte Prognoseaufgabe hinreichend sein und trotzdem keine vollständige Erklärung des zugrunde liegenden Phänomens liefern.
Mehr Modellkomplexität bedeutet nicht automatisch mehr Wirklichkeitsnähe
Buchaussage Kapitel 25 begründet Vereinfachung gerade damit, dass reale Situationen von sehr vielen Faktoren beeinflusst werden. Würde ein Modell versuchen, sämtliche denkbaren Eigenschaften und Beziehungen gleichzeitig abzubilden, wäre es häufig kaum noch handhabbar. Modellbildung benötigt deshalb Auswahl und Abstraktion.
Ein komplexeres Modell kann mehr Variablen, Parameter oder Wechselwirkungen berücksichtigen. Daraus folgt aber noch nicht, dass es den für die Fragestellung relevanten Ausschnitt der Wirklichkeit angemessener repräsentiert. Zusätzliche Komplexität kann ebenso irrelevante Muster aufnehmen oder die Prüfung der getroffenen Annahmen erschweren.
Einordnung Modellkomplexität ist daher kein Qualitätskriterium für sich. Entscheidend ist das Verhältnis zwischen Fragestellung, Daten, Annahmen, Generalisierungsleistung und Verwendungszweck. Ein einfacheres Modell kann für einen bestimmten Zweck angemessener sein als ein technisch aufwendigeres.
Die kritische Frage lautet somit nicht: Wie viel Wirklichkeit steckt maximal im Modell? Sondern: Welche Komplexität ist notwendig, um die relevante Frage belastbar zu beantworten, ohne Präzision oder Erkenntnissicherheit vorzutäuschen?
Ein guter Fit ist noch keine Wahrheit über die Wirklichkeit
Buchaussage Das Buch warnt vor Modellrealismus: Aus der Tatsache, dass ein Modell einen Wert berechnet oder bekannte Daten gut beschreibt, folgt nicht, dass seine Annahmen oder Aussagen automatisch wahr sind.
Statistischer Modellierungskontext NIST weist im Kontext statistischer Prozessmodellierung ausdrücklich darauf hin, dass ein hoher R²-Wert allein nicht garantiert, dass ein Modell die Daten angemessen beschreibt. Zusätzliche Modellvalidierung und die Prüfung von Annahmen sind erforderlich. NIST: How can I tell if a model fits my data?
Scope-Grenze NIST behandelt dort einen bestimmten statistischen Prozessmodellierungskontext. Die verantwortbare allgemeine Übertragung lautet daher nur: Eine einzelne Gütekennzahl reicht nicht automatisch aus, um die Angemessenheit eines Modells für seine Aufgabe zu begründen.
Das Modell beantwortet die Frage, die ihm gegeben wurde
Buchaussage Kapitel 26 zeigt, dass dieselben Ausgangsdaten zu unterschiedlichen Modellen führen können. Ein Online-Händler könnte vorhersagen wollen, wer kündigt, erneut kauft, hohe Servicekosten verursacht oder auf Werbung reagiert. Die Daten allein wählen diese Frage nicht aus.
Die Zielvariable bestimmt, was als Erfolg, Fehler oder relevante Vorhersage behandelt wird. Deshalb beginnt Modellkritik bereits vor der Auswahl eines Algorithmus.
Einordnung Ein technisch hervorragend trainiertes Modell kann daher das falsche Problem sehr präzise lösen. Modellqualität muss immer zusammen mit der ursprünglichen Fragestellung beurteilt werden.
Eine messbare Zielvariable kann ein Proxy für das eigentliche Ziel sein
Buchaussage Viele relevante Ziele lassen sich nicht direkt messen. Kundenzufriedenheit könnte beispielsweise über Beschwerden, Wiederkaufrate, Bewertungen oder Weiterempfehlungen operationalisiert werden. Jede dieser Größen erfasst jedoch nur bestimmte Aspekte.
Dass eine Zielvariable gut messbar ist, macht sie noch nicht identisch mit dem realen Ziel. Behandlungskosten sind etwa nicht dasselbe wie Krankheitsschwere; Zahl bearbeiteter Vorgänge ist nicht dasselbe wie Arbeitsqualität.
Proxy-Grenze Ein Proxy ist nicht automatisch schlecht. Er muss jedoch als Proxy erkennbar bleiben. Kritisches Denken fragt: Welche Teile des eigentlichen Ziels bildet diese Messgröße ab – und welche lässt sie systematisch unberücksichtigt?
Gute Ergebnisse auf bekannten Daten reichen nicht
Buchaussage Kapitel 27 behandelt den Train-Test-Split als Denkwerkzeug. Ein Modell soll nicht nur bekannte Fälle reproduzieren, sondern seine gelernte Struktur auch auf bisher unbekannte Beobachtungen übertragen können.
Aktuelle ML-Dokumentation Die aktuelle scikit-learn-Dokumentation formuliert diese Grenze ausdrücklich: Das Fitten eines Modells auf Daten bedeutet nicht, dass es auf ungesehenen Daten gut vorhersagt; dies muss direkt bewertet werden. scikit-learn: Model evaluation
Generalisierungsgrenze Auch gute Testleistung ist keine Garantie für jede zukünftige Situation. Populationen können sich verändern, neue Randbedingungen können auftreten und ein zufälliger Split kann bestimmte reale Einsatzbedingungen nur unzureichend repräsentieren.
Aktuelle Tech-Dokumentation
train_test_split() teilt Daten in Trainings- und
Testteilmengen. Standardmäßig gilt
shuffle=True. Ein ganzzahlig gesetztes
random_state steuert die Zufallsaufteilung so,
dass wiederholte Funktionsaufrufe reproduzierbare Ergebnisse
liefern können. Mit stratify kann die Aufteilung
optional anhand angegebener Klassenlabels geschichtet werden;
bei shuffle=False muss
stratify=None gelten.
scikit-learn: train_test_split
Methodenpräzisierung Ein zufälliger Train-Test-Split ist jedoch keine universelle Validierungsstrategie. Zeitabhängige, gruppierte oder andere strukturierte Daten können Splitverfahren benötigen, die diese Struktur ausdrücklich berücksichtigen.
Viele Nachkommastellen machen ein Modell nicht sicherer
Buchaussage Kapitel 25 warnt vor scheinbarer Präzision. Eine Modellwahrscheinlichkeit wie 87,4362 Prozent wirkt exakt. Die Zahl kann rechnerisch korrekt sein und trotzdem auf begrenzten Daten, Annahmen oder einer unvollständigen Repräsentation beruhen.
Numerische Genauigkeit beschreibt zunächst die Darstellung eines Ergebnisses. Erkenntnissicherheit betrifft dagegen die Belastbarkeit der zugrunde liegenden Schlussfolgerung.
Einordnung Deshalb sollte die Zahl der ausgegebenen Dezimalstellen nicht mit empirischer Sicherheit verwechselt werden. Ein Modell kann sehr präzise rechnen und trotzdem systematisch am relevanten Teil der Wirklichkeit vorbeimodellieren.
Ein Modelloutput ist noch keine Entscheidung
Buchaussage Das Buch trennt Modellberechnung und verantwortliche Entscheidung. Ein Kreditmodell kann beispielsweise ein Risiko schätzen. Daraus folgt nicht automatisch, welche Handlung gegenüber einer konkreten Person gerechtfertigt ist.
Zusätzlich können Fehlerkosten, rechtliche Anforderungen, fachliche Ziele, Alternativen und Auswirkungen auf Betroffene relevant sein. Diese Kriterien liegen nicht vollständig im Vorhersagewert selbst.
Verantwortungsgrenze Je folgenreicher der Einsatz, desto problematischer wäre die Abkürzung „Das Modell sagt X, also tun wir Y“. Zwischen Vorhersage und Handlung liegt ein zusätzlicher Begründungs- und Entscheidungsschritt.
Zehn Fragen an jedes Modell
Redaktionelle Synthese Aus den Buchkapiteln und den eng abgegrenzten externen Quellen ergibt sich folgende Prüfroutine:
- Welchen Ausschnitt der Wirklichkeit beschreibt das Modell?
- Welcher Zweck bestimmt die Auswahl und Vereinfachung?
- Welche Informationen fehlen schon im Datensatz?
- Welche weiteren Annahmen führt das Modell ein?
- Welche Zielvariable wird tatsächlich optimiert oder vorhergesagt?
- Ist diese Zielvariable das eigentliche Ziel oder nur ein Proxy?
- Wie wurde Modellgüte geprüft – und reicht eine einzelne Kennzahl dafür aus?
- Wie verhält sich das Modell auf wirklich unbekannten Daten?
- Für welche Populationen, Zeiträume und Bedingungen wurde es nicht geprüft?
- Welche zusätzliche Begründung ist zwischen Modelloutput und Entscheidung nötig?
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Kritisches Denken in Data Science mit Python , veröffentlichte BookRix-EPUB, insbesondere Kapitel 24–27.
Externe Kontextquellen Stanford Encyclopedia of Philosophy zu wissenschaftlichen Modellen und Repräsentation, NIST zur Validierung statistischer Prozessmodelle sowie aktuelle scikit-learn-Dokumentation zur Evaluation auf unbekannten Daten.
Die externen Quellen werden nicht als Beleg für die gesamte Buchthese verwendet. Sie sichern jeweils nur eng umrissene Aussagen zu Repräsentation, Modellvalidierung und Generalisierung ab.
Zur allgemeinen redaktionellen Vorgehensweise: Quellen und Arbeitsweise .
Ein Modell ist eine Perspektive auf Wirklichkeit – nicht ihr Ersatz
Gute Modellkritik fragt nicht nur, ob ein Algorithmus technisch funktioniert. Sie prüft, was überhaupt modelliert wurde, welche Annahmen und Auslassungen darin stecken, für welchen Zweck das Modell validiert wurde und welche zusätzliche Begründung vor einer realen Entscheidung erforderlich bleibt.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.