MODELLE KRITISCH BEURTEILEN · FRAGE 9 VON 12
Wie beurteilt man Machine-Learning-Modelle jenseits einer Kennzahl?
Eine hohe Accuracy, ein guter F1-Score oder eine starke AUC können wichtige Informationen liefern. Keine dieser Kennzahlen beantwortet jedoch allein, welche Fehler ein Modell macht, welche Folgen diese Fehler haben, welcher Schwellenwert angemessen ist und ob die Leistung auf unbekannten Daten Bestand hat. Verantwortbare Modellbewertung verbindet deshalb mehrere Perspektiven statt eine Zahl zum Gesamturteil zu machen.
Kurzantwort: Ein Machine-Learning-Modell sollte nicht nur danach beurteilt werden, wie hoch eine Kennzahl ist. Kritisches Prüfen fragt mindestens nach Fehlertypen, Klassenverteilung, Precision und Recall, dem gewählten Schwellenwert, ROC/AUC, möglichem Overfitting und der Leistung auf wirklich unbekannten Daten. Erst danach folgt die fachliche Frage, ob die verbleibenden Fehler und Risiken für den konkreten Einsatz vertretbar sind.
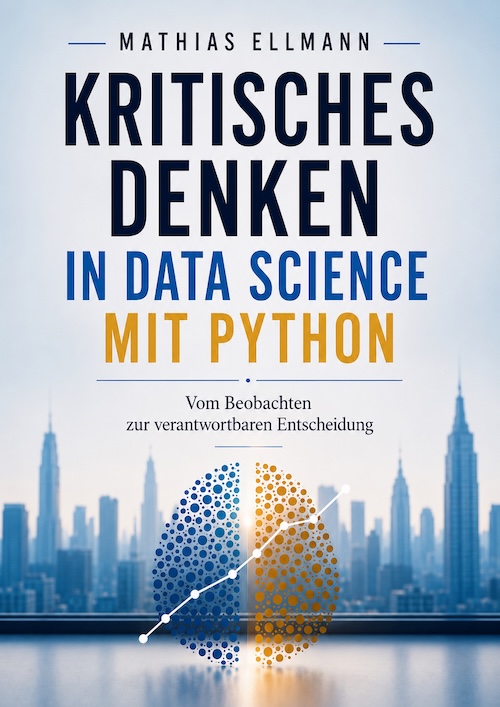
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Kritisches Denken in Data Science mit Python
Vom Beobachten zur verantwortbaren Entscheidung
Primäre Buchgrundlage: Kapitel 28 bis 31: Confusion Matrix, ROC/AUC, Overfitting sowie die Grenze zwischen Kennzahl und Entscheidung.
Eine Kennzahl beantwortet immer nur eine bestimmte Frage
Buchaussage Kapitel 31 beschreibt Kennzahlen als unverzichtbare Verdichtungen. Sie ermöglichen Vergleiche, machen bestimmte Fehler sichtbar und helfen bei der Evaluation. Problematisch wird es erst, wenn aus einer einzelnen Messgröße ein Gesamturteil über das Modell oder sogar eine Entscheidung abgeleitet wird.
Accuracy beantwortet eine andere Frage als Recall. Recall beantwortet eine andere Frage als Precision. AUC wiederum betrachtet Trennleistung über Schwellenwerte hinweg. Keine dieser Perspektiven enthält automatisch alle anderen.
Einordnung Die zentrale Frage lautet daher nicht: Welche Kennzahl ist die beste? Sondern: Welche Eigenschaft des Modells muss für die konkrete Entscheidung beurteilt werden – und welche Kennzahlen machen diese Eigenschaft sichtbar?
Die Confusion Matrix zeigt, welche Art von Fehler entsteht
Buchaussage Kapitel 28 trennt True Positives, True Negatives, False Positives und False Negatives. Diese Unterscheidung ist entscheidend, weil zwei Modelle mit ähnlicher Gesamtzahl korrekter Vorhersagen völlig unterschiedliche Fehlerprofile besitzen können.
Ein False Negative kann in einer medizinischen Anwendung bedeuten, dass ein relevanter Krankheitsfall übersehen wird. Ein False Positive kann dagegen eine unnötige weitere Untersuchung auslösen. Beide sind Fehler, aber ihre Folgen müssen nicht gleich sein.
Aktuelle Tech-Dokumentation In der aktuellen scikit-learn-Konvention stehen in der Confusion Matrix die tatsächlichen Klassen in den Zeilen und die vorhergesagten Klassen in den Spalten. Für den binären Fall mit der Reihenfolge 0, 1 ergeben sich daraus TN, FP, FN und TP an den entsprechenden Matrixpositionen. scikit-learn: confusion_matrix
Präzisionsgrenze Beim Lesen einer Confusion Matrix sollte die Achsen- und Klassenreihenfolge immer ausdrücklich geprüft werden. Andere Darstellungen können eine andere visuelle Konvention verwenden.
Hohe Accuracy kann relevante Fehler verdecken
Buchaussage Das Buch warnt ausdrücklich davor, Accuracy mit vollständiger Modellqualität gleichzusetzen. Bei seltenen positiven Fällen kann schon ein Modell, das fast immer die Mehrheitsklasse vorhersagt, eine hohe Accuracy erreichen und trotzdem den eigentlich interessierenden Fall kaum erkennen.
Genau deshalb muss die Klassenverteilung mitgelesen werden. Eine Accuracy von 99 Prozent hat eine andere Bedeutung, wenn 99 Prozent aller Fälle ohnehin zur selben Klasse gehören, als bei zwei ähnlich häufigen Klassen.
Aktuelle Tech-Dokumentation
scikit-learn stellt für unausgeglichene Klassifikationsprobleme
unter anderem balanced_accuracy_score() bereit.
Die scikit-learn-Dokumentation definiert Balanced Accuracy
für binäre und Multiclass-Klassifikation als Durchschnitt des
Recall über die Klassen und ordnet die Kennzahl ausdrücklich
als Werkzeug für unausgeglichene Datensätze ein.
scikit-learn: balanced_accuracy_score
Grenze Daraus folgt nicht, dass Balanced Accuracy automatisch die richtige Zielmetrik ist. Sie beantwortet lediglich eine andere, bei Klassenungleichgewicht häufig informativere Frage.
Precision und Recall betrachten unterschiedliche Fehlerseiten
Buchaussage Das Buch und sein Metrik-Anhang unterscheiden klar: Precision fragt, welcher Anteil der positiv vorhergesagten Fälle tatsächlich positiv ist. Recall fragt, welcher Anteil der tatsächlich positiven Fälle erkannt wurde.
Damit verschieben beide Kennzahlen den Blick. Hohe Precision verlangt wenige False Positives. Hoher Recall verlangt wenige False Negatives. Welche Seite wichtiger ist, hängt vom Anwendungskontext ab.
Aktuelle Tech-Dokumentation
scikit-learn definiert Precision als
TP / (TP + FP) und Recall als
TP / (TP + FN). Die API kann Precision, Recall,
F-Measure und Support klassenweise berechnen.
scikit-learn: precision_recall_fscore_support
Entscheidungsgrenze „Recall maximieren“ oder „Precision maximieren“ ist deshalb keine kontextfreie Qualitätsregel. Man muss wissen, welche Folgen zusätzliche Fehlalarme und übersehene positive Fälle tatsächlich haben.
Der Schwellenwert verändert das konkrete Fehlerprofil
Buchaussage Kapitel 28 und 29 zeigen, dass viele Klassifikatoren zunächst einen Score oder eine Wahrscheinlichkeit erzeugen. Erst ein Schwellenwert macht daraus eine konkrete positive oder negative Klassifikation.
Wird der Schwellenwert verändert, können sich True Positives, False Positives, False Negatives und damit auch Precision, Recall und die Confusion Matrix verändern. Der Score eines einzelnen Falls muss sich dafür nicht ändern.
Aktuelle Tech-Dokumentation
roc_curve() berechnet für binäre Klassifikation
False-Positive-Rate und True-Positive-Rate für unterschiedliche
Score-Schwellenwerte.
scikit-learn: roc_curve
Präzisionsgrenze Ein niedrigerer Schwellenwert kann den Recall erhöhen und häufig zusätzliche False Positives erzeugen. Precision muss dabei jedoch nicht streng monoton sinken. Der konkrete Verlauf hängt von der Reihenfolge der Modell-Scores ab.
AUC beschreibt Trennleistung – nicht den richtigen Einsatzpunkt
Buchaussage Kapitel 29 verwendet ROC und AUC, um die Trennfähigkeit eines Klassifikationsmodells über unterschiedliche Schwellenwerte hinweg zu betrachten. Eine hohe AUC kann gute Trennleistung anzeigen, legt aber noch keinen fachlich richtigen Schwellenwert fest.
Ein Modell kann deshalb eine überzeugende AUC besitzen und bei einem ungeeigneten konkreten Schwellenwert dennoch zu viele kritische Fälle übersehen oder zu viele Fehlalarme erzeugen.
Aktuelle Tech-Dokumentation
roc_auc_score() berechnet ROC AUC aus
Vorhersagescores. Die aktuelle API unterstützt binäre,
Multiclass- und Multilabel-Situationen mit jeweils zu
beachtenden Parametern und Einschränkungen.
scikit-learn: roc_auc_score
Grenze AUC beantwortet nicht die Frage, welche Fehlerkosten vertretbar sind. Sie ist eine Analysegröße, keine automatische Einsatzentscheidung.
Bei seltenen positiven Fällen lohnt zusätzlich der Blick auf Precision und Recall
Buchaussage Kapitel 29 weist darauf hin, dass ROC-Kurven bei stark unausgeglichenen Klassen ein unvollständiges praktisches Bild vermitteln können und Precision-Recall-Kurven dann zusätzlich hilfreich sein können.
Das ist besonders relevant, wenn die positive Klasse selten und gleichzeitig fachlich wichtig ist – etwa bei Betrug, seltenen Defekten oder bestimmten medizinischen Befunden.
Aktuelle Tech-Dokumentation Das aktuelle scikit-learn-Beispiel bezeichnet Precision-Recall ausdrücklich als nützliche Erfolgsdarstellung, wenn Klassen stark unausgeglichen sind, und zeigt den Trade-off über unterschiedliche Schwellenwerte. scikit-learn: Precision-Recall
Einordnung Daraus folgt nicht „Precision-Recall statt ROC“. Beide Perspektiven können sinnvoll sein. Entscheidend ist, welche Fehlerstruktur für die konkrete Frage sichtbar werden muss.
Auch der F1-Score ist eine bewusste Zusammenfassung
Buchaussage Der Metrik-Anhang des Buches beschreibt F1 als Kombination von Precision und Recall. Der Wert ist hilfreich, wenn beide Größen gemeinsam betrachtet werden sollen.
Gerade diese Verdichtung besitzt aber eine Grenze: Zwei unterschiedliche Precision-Recall-Kombinationen können zu ähnlichen F1-Werten führen, obwohl ihre praktischen Folgen verschieden sind.
Aktuelle Tech-Dokumentation
scikit-learn definiert F1 als harmonisches Mittel von Precision
und Recall. Bei F1 beziehungsweise
beta=1 werden Precision und Recall innerhalb
dieser Berechnung gleich gewichtet. Für Multiclass- und
Multilabel-Aufgaben hängt ein zusammengefasster F1-Wert
zusätzlich von der gewählten average-Strategie
ab.
scikit-learn: f1_score
Kosten-Grenze Ein F1-Score bildet deshalb nicht automatisch reale Fehlerkosten ab. Wenn ein False Negative zehnmal schwerer wiegt als ein False Positive, steckt diese Gewichtung nicht allein dadurch im F1-Wert.
Sehr gute Trainingsleistung kann ein Warnsignal sein
Buchaussage Kapitel 30 beschreibt Overfitting als Situation, in der ein Modell nicht nur tragfähige Muster, sondern auch Besonderheiten und Rauschen der Trainingsdaten lernt. Auf bekannten Daten kann es dadurch beeindruckend wirken und auf neuen Fällen deutlich schwächer werden.
Hohe Trainingsleistung ist damit kein Beweis für Erkenntnis. Besonders problematisch wird es, wenn Komplexität und genaue Anpassung an die Vergangenheit mit Generalisierungsfähigkeit verwechselt werden.
Aktuelle ML-Dokumentation scikit-learn formuliert diese Grenze direkt: Ein Modell an Daten anzupassen bedeutet nicht, dass es auf ungesehenen Daten gut vorhersagt. Diese Leistung muss gesondert evaluiert werden. scikit-learn: Model evaluation
Generalisierungsgrenze Auch gute Testleistung beweist nicht, dass alle zukünftigen Populationen, Zeiträume oder Randbedingungen abgedeckt sind. Sie ist Evidenz innerhalb des gewählten Evaluationsdesigns.
Mehrere Metriken sollten auf mehreren geeigneten Splits betrachtet werden
Aktuelle Tech-Dokumentation
cross_validate() kann ein Modell über mehrere
Cross-Validation-Splits hinweg evaluieren und unterstützt auch
mehrere Scorer gleichzeitig.
scikit-learn: cross_validate
Damit lassen sich beispielsweise Accuracy, Precision, Recall oder andere für die Fragestellung relevante Größen nicht nur als einzelne Punktwerte, sondern über mehrere Datenaufteilungen betrachten.
Methodenpräzisierung Mehr Cross-Validation und mehr Kennzahlen garantieren dennoch keine gute Evaluation. Die Splitstrategie muss zur Datenstruktur passen; zeitliche oder gruppierte Daten können andere Verfahren erfordern. Außerdem muss schon vor der Auswertung geklärt sein, welche Metriken für den Entscheidungskontext tatsächlich relevant sind.
Ein wiederholt zur Modellauswahl genutztes Testset verliert seine Rolle als unabhängige Endprüfung
Buchaussage Kapitel 30 nennt die unkritische wiederholte Verwendung von Testdaten ausdrücklich als Denkfehler. Wenn Modellvarianten, Features oder Hyperparameter immer wieder danach verändert werden, wie gut sie auf demselben Testbestand abschneiden, fließt Information aus diesem Bestand indirekt in die Entwicklung ein.
Dann kann die Datei technisch weiterhin „Testset“ heißen, methodisch dient sie jedoch nicht mehr als vollständig unberührte Endprüfung. Wiederholte Anpassungen an ihre Ergebnisse können die gemessene Generalisierungsleistung optimistisch verzerren.
Prüfregel Kritische Evaluation fragt deshalb nicht nur „Wie hoch ist der Testscore?“, sondern auch: Wie oft und für welche Entwicklungsentscheidungen wurde dieser Testbestand bereits betrachtet?
Die gleiche Zahl von Fehlern kann sehr unterschiedliche Folgen haben
Buchaussage Kapitel 31 macht deutlich, dass Kennzahlen nicht sämtliche Folgen eines Modells erfassen. Zwei Fehlerarten können statistisch jeweils als ein Fehlfall gezählt werden und praktisch trotzdem völlig unterschiedlich schwer wiegen. Deshalb reicht die Häufigkeit eines Fehlers nicht aus, um seine Bedeutung für eine Entscheidung zu bestimmen.
Ein False Positive kann beispielsweise zusätzliche Prüfung, Kosten oder unnötige Belastung auslösen. Ein False Negative kann dagegen bedeuten, dass ein relevanter Fall unentdeckt bleibt. Welche Konsequenz schwerer wiegt, lässt sich nicht aus den Bezeichnungen False Positive und False Negative allein ableiten.
Entscheidungsbezogene Einordnung Kritische Modellbewertung benötigt deshalb neben den Fehlerraten ein explizites Folgenmodell: Wer trägt die Folgen eines Fehlers? Wie schwer sind sie? Sind sie reversibel? Welche Alternative hätte andere Fehler? Erst diese Fragen verbinden statistische Evaluation mit dem realen Entscheidungskontext.
Damit wird auch verständlich, warum zwei Modelle mit ähnlichem F1-Score, ähnlicher Accuracy oder ähnlicher AUC im selben Anwendungsfeld unterschiedlich geeignet sein können. Die Kennzahlen beschreiben Eigenschaften der Vorhersagen; die Bewertung ihrer Folgen benötigt zusätzliche fachliche Kriterien.
Gute Kennzahlen garantieren noch keine gute Entscheidung
Buchaussage Kapitel 31 zieht die entscheidende Grenze: Kennzahlen liefern Informationen, treffen aber keine Entscheidungen. Ein medizinisches Modell kann mathematisch sehr gut abschneiden und trotzdem eine problematische Zahl unnötiger Untersuchungen auslösen. In anderen Anwendungen können Fehlentscheidungen finanzielle, rechtliche oder gesellschaftliche Folgen haben.
Modellbewertung benötigt deshalb eine Verbindung zwischen Statistik und Entscheidung: Welche Fehlerart entsteht? Wie häufig? Für wen? Mit welchen Konsequenzen? Welche Alternative gäbe es? Und welcher Schwellenwert verändert diese Fehlerverteilung?
Verantwortungsgrenze Die Kennzahl beendet die Argumentation also nicht. Sie liefert einen Baustein dafür. Erst durch den fachlichen Kontext wird aus „AUC 0,89“ oder „Recall 95 Prozent“ eine begründbare Aussage darüber, ob ein Modell für einen bestimmten Einsatz tragfähig erscheint.
Zwölf Fragen für eine belastbare Modellbewertung
Redaktionelle Synthese Aus den Buchkapiteln und den eng abgegrenzten technischen Quellen ergibt sich folgende Prüfroutine:
- Welche Klassen kommen wie häufig vor?
- Welche False Positives und False Negatives entstehen?
- Welche Fehlerart hat die schwereren Folgen?
- Was zeigt Accuracy – und was verdeckt sie?
- Wie verhalten sich Precision und Recall?
- Welcher Schwellenwert erzeugt dieses Fehlerprofil?
- Was zeigt ROC/AUC unabhängig vom konkreten Einsatzpunkt?
- Ist bei Klassenungleichgewicht zusätzlich Precision-Recall relevant?
- Welche Information geht in einer zusammengefassten Kennzahl wie F1 verloren?
- Wie stabil sind die Ergebnisse über geeignete Datenaufteilungen?
- Wurde der Testbestand wirklich unabhängig gehalten?
- Sind die verbleibenden Fehler für den konkreten Einsatz vertretbar?
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Kritisches Denken in Data Science mit Python , veröffentlichte BookRix-EPUB, insbesondere Kapitel 28–31 sowie der Metrik-Anhang.
Technische API-Definitionen und aktuelle Implementierungsgrenzen wurden mit der stabilen scikit-learn-Dokumentation abgeglichen.
Die externen Quellen dienen ausschließlich der technischen Präzisierung von Metriken und Evaluationsverfahren. Die Entscheidung darüber, welche Fehlerfolgen vertretbar sind, bleibt eine fachliche und normative Bewertung.
Zur allgemeinen redaktionellen Vorgehensweise: Quellen und Arbeitsweise .
Ein Modell ist mehr als sein bester Score
Verantwortbare Evaluation macht sichtbar, welche Fehler auftreten, wie Schwellenwerte sie verändern, wie stabil die Leistung auf unbekannten Daten bleibt und welche Folgen diese Fehler im realen Einsatz besitzen.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.