STATISTIK & VISUALISIERUNG · FRAGE 7 VON 12
Wie liest man deskriptive Statistik und Visualisierungen kritisch?
Kennzahlen und Diagramme verdichten Daten. Gerade dadurch sind sie nützlich – und interpretationsbedürftig. Ein Mittelwert kann Ausreißer verdecken, ein Anteil benötigt eine Bezugsgröße, ein Histogramm hängt von seiner Klasseneinteilung ab und eine Achse verändert, wie groß Unterschiede erscheinen. Kritisches Lesen fragt deshalb immer, welche Information sichtbar wird und welche durch die Verdichtung verloren geht.
Kurzantwort: Deskriptive Statistik beschreibt einen Datensatz, erklärt ihn aber nicht automatisch. Kritisches Lesen kombiniert Lage, Streuung, Verteilung, Gruppengröße und mögliche Ausreißer. Bei Diagrammen kommen weitere Entscheidungen hinzu: Auswahl der Daten, Aggregation, Achsenskalierung, Bins, Farben und Bezugsgrößen. Eine Darstellung ist deshalb weder beliebig noch neutral; ihre Aussagekraft hängt davon ab, ob Darstellung und Erkenntnisanspruch zueinander passen.
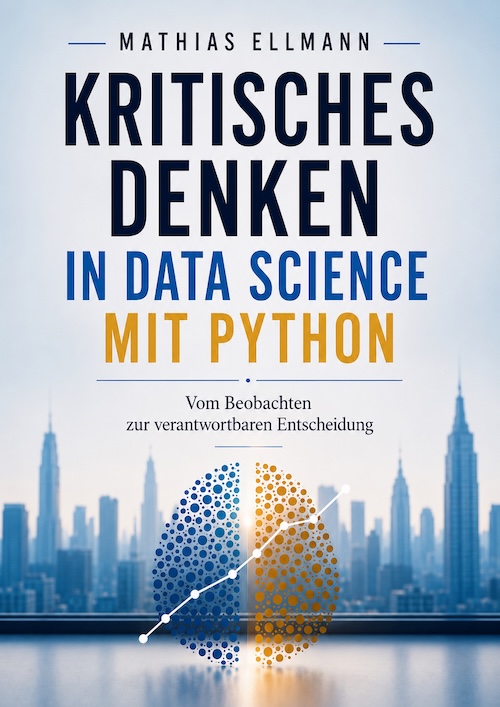
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Kritisches Denken in Data Science mit Python
Vom Beobachten zur verantwortbaren Entscheidung
Primäre Buchgrundlage: Kapitel 21 über deskriptive Statistik und Kapitel 22 über Visualisierungen als Argumente.
Jede Kennzahl ist eine Verdichtung
Buchaussage Kapitel 21 behandelt deskriptive Statistik als Werkzeug, um Beobachtungen zusammenzufassen. Mittelwert, Median, Standardabweichung, Quartile und Häufigkeiten machen einen Datensatz übersichtlicher. Dabei geht jedoch zwangsläufig Detailinformation verloren.
Eine einzelne Zahl kann deshalb sehr nützlich sein, ohne den Datensatz vollständig zu charakterisieren. Zwei Gruppen können denselben Mittelwert besitzen und sich trotzdem erheblich in Streuung, Ausreißern oder Verteilungsform unterscheiden.
Einordnung Die richtige Frage lautet nicht: „Welche Kennzahl ist die wahre?“ Sondern: Welche Eigenschaft des Datensatzes fasst diese Kennzahl zusammen – und welche relevante Information bleibt dabei unsichtbar?
Der Mittelwert ist nicht automatisch der typische Fall
Buchaussage Das Buch zeigt am Beispiel stark unterschiedlicher Einkommen, dass einzelne extreme Werte den Mittelwert deutlich verschieben können. Der Durchschnitt kann dann höher liegen als die Werte, die für die meisten Beobachtungen charakteristisch erscheinen.
Der Median beantwortet eine andere Frage: Er teilt die sortierten Beobachtungen so, dass ungefähr die Hälfte darunter und die andere Hälfte darüber liegt. Auch der Median ist jedoch keine universell bessere Kennzahl.
Statistischer Kontext Das NIST Engineering Statistics Handbook unterscheidet verschiedene Lagemaße. Bei symmetrischen Verteilungen können Mittelwert und Median nahe beieinanderliegen; bei schiefen Verteilungen können sie sich deutlich unterscheiden. NIST: Measures of Location
Grenze Daraus folgt weder „Median ist immer besser“ noch „Mittelwert ist bei Schiefe grundsätzlich falsch“. Die Wahl hängt davon ab, welche Eigenschaft der Verteilung für die konkrete Frage relevant ist.
Lage ohne Streuung kann ein falsches Bild erzeugen
Buchaussage Kapitel 21 ergänzt Lagekennzahlen durch Quartile und Standardabweichung. Erst dadurch wird sichtbar, wie eng oder weit Beobachtungen um einen zentralen Bereich verteilt sind.
Eine kleine Streuung ist dabei nicht automatisch „gut“ und eine große Streuung nicht automatisch „schlecht“. Die Streuung kann reale Heterogenität, unterschiedliche Teilgruppen, Messprobleme oder schlicht die natürliche Variabilität eines Prozesses widerspiegeln.
Statistischer Kontext NIST weist darauf hin, dass unterschiedliche Streuungsmaße unterschiedliche Teile einer Verteilung gewichten. Für Verteilungen mit langen Tails können beispielsweise robuste Alternativen wie Interquartilsabstand oder Median Absolute Deviation andere Eigenschaften besitzen als die Standardabweichung. NIST: Measures of Scale
Einordnung Eine Standardabweichung sollte daher zusammen mit Verteilungsform, Lage und fachlichem Kontext gelesen werden, nicht als isoliertes Qualitätsurteil über einen Datensatz.
Gleicher Mittelwert bedeutet nicht gleiche Verteilung
Buchaussage Kapitel 21 behandelt Lagekennzahlen ausdrücklich als Verdichtungen eines Datensatzes. Deshalb sollte ein Mittelwert nicht isoliert gelesen werden. Erst zusammen mit Streuung, Quartilen, Verteilungsform und möglichen Ausreißern wird erkennbar, wie die einzelnen Beobachtungen tatsächlich verteilt sind.
Redaktionelles Beispiel Zwei kleine Datenreihen verdeutlichen das: 48, 49, 50, 51, 52 und 0, 25, 50, 75, 100. Beide besitzen den Mittelwert 50 und sogar denselben Median. Trotzdem beschreiben sie offensichtlich sehr unterschiedliche Verteilungen. In der ersten Reihe liegen alle Werte eng beieinander; in der zweiten reichen sie von 0 bis 100.
Wer nur den Durchschnitt berichtet, würde diesen Unterschied vollständig verlieren. Umgekehrt ist auch eine Streuungskennzahl allein keine vollständige Beschreibung. Verteilungen können trotz ähnlicher Lage und Streuung unterschiedliche Schiefe, Ausreißer oder mehrere Häufungsbereiche besitzen.
Kritisches Lesen kombiniert deshalb mehrere Perspektiven: Lage, Streuung, Verteilungsform und – wo relevant – die einzelnen ungewöhnlichen Beobachtungen. Die Kennzahlen ergänzen einander; keine einzelne von ihnen ersetzt den Blick auf die Struktur des Datensatzes.
Ein Ausreißer ist eine Frage – noch kein Datenfehler
Buchaussage Das Buch nennt mehrere mögliche Bedeutungen ungewöhnlicher Werte: reale seltene Fälle, Messfehler, Eingabefehler, besondere Gruppen oder Hinweise auf neue Hypothesen.
Eine formale Regel – etwa eine auf Quartilen beruhende Ausreißergrenze – kann Beobachtungen markieren. Sie entscheidet aber nicht, warum ein Wert ungewöhnlich ist und ob er entfernt werden darf.
Prüfregel Vor dem Ausschluss eines Extremwerts sollte deshalb geklärt werden, ob er technisch unmöglich, fachlich unplausibel, fehlerhaft erhoben oder gerade wegen seiner Seltenheit analytisch wichtig ist. Ein automatisches „Ausreißer löschen“ kann genau die Beobachtungen entfernen, die erklärt werden müssten.
Absolute Zahlen brauchen eine Bezugsgröße
Buchaussage Kapitel 21 warnt davor, absolute Häufigkeiten und Prozentwerte gedankenlos zu vermischen. Eine große Gruppe enthält häufig schon wegen ihrer Größe mehr Fehler, Beschwerden oder Kündigungen als eine kleine Gruppe.
Beispiel: 100 Beschwerden in einer Gruppe mit 10.000 Personen und 40 Beschwerden in einer Gruppe mit 500 Personen ergeben sehr unterschiedliche Bilder, je nachdem ob absolute Anzahl oder Anteil betrachtet wird.
Aktuelle Tech-Dokumentation
Die pandas-API unterstützt mit
value_counts(normalize=True) relative
Häufigkeiten beziehungsweise Anteile anstelle bloßer Counts.
Standardmäßig werden dabei NA-Werte nicht mitgezählt
(dropna=True); die normalisierten Anteile beziehen
sich daher auf die gezählten, nicht fehlenden Werte.
Mit dropna=False können fehlende Werte in die
Häufigkeitstabelle einbezogen werden.
pandas: Series.value_counts
Grenze Prozentwerte sind deshalb nicht automatisch „besser“. Entscheidend ist die richtige Bezugsgröße: Anteil wovon? Unterschiedliche Denominatoren können dieselben Rohdaten in unterschiedliche fachliche Aussagen verwandeln.
Histogramme zeigen Verteilungen – abhängig von ihrer Klasseneinteilung
Buchaussage Kapitel 22 weist darauf hin, dass die Zahl der Klassen beziehungsweise Bins beeinflusst, welche Struktur in einem Histogramm sichtbar wird. Zu grobe Klassen können Muster verdecken; sehr feine Klassen können zufällige Schwankungen prominent erscheinen lassen.
Statistischer Kontext NIST beschreibt Histogramme als grafische Zusammenfassung univariater Daten, die unter anderem Hinweise auf Lage, Streuung, Schiefe, Ausreißer und mehrere Modi liefern kann. Ein Histogramm entsteht durch die Aufteilung des Wertebereichs in Klassen und die Zählung der Beobachtungen je Klasse. NIST: Histogram
Grenze Ein sichtbar zweigipfliges Histogramm kann eine interessante Hypothese über Teilgruppen anregen. Es beweist allein jedoch noch nicht, dass tatsächlich zwei getrennte Populationen oder Prozesse vorliegen.
Eine abgeschnittene Achse ist ein Warnsignal – aber nicht immer falsch
Buchaussage Kapitel 22 zeigt, dass identische Umsatzdaten dramatisch unterschiedlich wirken können, wenn die y-Achse einmal einen großen Wertebereich und einmal nur den engen Bereich der beobachteten Werte zeigt.
Gerade bei Balkendiagrammen ist das besonders relevant, weil die Länge des Balkens selbst die Größenrelation vermittelt. Wird die Basis abgeschnitten, können kleine Unterschiede visuell sehr groß erscheinen.
Visualisierungsleitlinie Die aktuelle ONS-Leitlinie differenziert nach Diagrammtyp: Balken- und Flächendiagramme sollen an der relevanten Größenachse bei null beginnen. Bei Linien- und Streudiagrammen kann die Achse bei Bedarf gekürzt werden, um die Daten klarer lesbar zu machen. ONS weist zugleich darauf hin, dass ein Start bei null häufig weiterhin vorzuziehen ist, wenn der Trend damit noch klar erkennbar bleibt. ONS: Axes and gridlines
Präzisionsgrenze Die kritische Regel lautet deshalb nicht „jede Achse muss bei null beginnen“. Besser ist: Passt die Skala zur visuellen Kodierung, und kann ein Leser die Größenordnung des gezeigten Unterschieds korrekt einschätzen?
Eine Linie verbindet auch dort, wo möglicherweise nichts gemessen wurde
Buchaussage Kapitel 22 weist bei Zeitreihen darauf hin, dass eine Linie zwischen zwei Messpunkten einen kontinuierlichen Verlauf suggeriert. Tatsächlich kann zwischen den Messzeitpunkten keine Beobachtung vorliegen.
Diese Verbindung ist häufig sinnvoll und erwartbar. Sie bleibt aber eine grafische Konstruktion. Bei großen zeitlichen Abständen oder stark volatilen Prozessen kann der tatsächliche Verlauf zwischen zwei Punkten erheblich von einer geraden Linie abweichen.
Einordnung Kritisches Lesen trennt deshalb Messpunkte von Interpolation: Was wurde tatsächlich beobachtet und welche Kontinuität entsteht erst durch die Darstellungsform?
Ein sichtbarer Zusammenhang erklärt noch keine Ursache
Buchaussage Streudiagramme können Zusammenhänge zwischen zwei numerischen Merkmalen sichtbar machen. Das Buch zieht aber dieselbe Grenze wie bei Korrelationen: Ein sichtbares Muster beweist keine Kausalität.
Cluster, Kurven oder Trends können wichtige Fragen erzeugen. Die Erklärung benötigt jedoch zusätzliche Annahmen und Untersuchungen. Ein dritter Faktor kann beide Variablen beeinflussen; die Wirkungsrichtung kann ungeklärt sein oder das Muster nur für bestimmte Teilgruppen gelten.
Einordnung Ein Diagramm ist damit häufig ein hervorragendes Werkzeug zur Hypothesenbildung. Es sollte aber nicht unbemerkt vom Explorationswerkzeug zum Kausalbeweis werden.
Eine Punktschätzung kann ihre eigene Unsicherheit verbergen
Diagramme zeigen häufig nur eine zentrale Schätzung: einen Mittelwert, eine Quote oder eine modellierte Entwicklung. Wenn diese Größe jedoch aus Stichproben oder Schätzverfahren stammt, kann ihre Unsicherheit für die Interpretation wesentlich sein.
Visualisierungsleitlinie Die ONS-Leitlinie empfiehlt, Unsicherheit dann sichtbar zu machen, wenn sie für das Verständnis zentraler Trends wichtig ist oder die Interpretation wesentlich verändern kann. Zugleich soll Unsicherheit nicht zusätzlich visualisiert werden, wenn sie für die Interpretation nicht erforderlich ist. Für Linien nennt die Leitlinie unter anderem schattierte Unsicherheitsbänder um zentrale Schätzungen. ONS: Showing uncertainty in charts
Grenze Das bedeutet nicht, dass jedes Balkendiagramm ein Konfidenzintervall benötigt. Erst muss geklärt werden, welche Art von Unsicherheit vorliegt. Ein vollständig erhobener deskriptiver Bestand, eine Stichprobenschätzung und eine Modellprognose stellen unterschiedliche Anforderungen an die Unsicherheitskommunikation.
Diagramme zeigen – und rahmen zugleich
Buchaussage Kapitel 22 bezeichnet Visualisierungen als Argumente, weil bereits ihre Konstruktion Entscheidungen enthält: Welche Daten werden gezeigt? Welcher Zeitraum? Welche Variablen? Welche Skala? Welche Aggregation? Welche Fälle fehlen?
Das bedeutet nicht, dass jede Visualisierung manipulativ wäre. Auswahl ist unvermeidbar. Verantwortlich wird sie dadurch, dass die Auswahl zur Fragestellung passt und keine wesentlich andere Interpretation nahelegt, als die zugrunde liegenden Daten tragen.
Redaktionelle Synthese Kritisches Lesen richtet sich deshalb auf drei Ebenen: Datenbasis, statistische Verdichtung und visuelle Kodierung. Eine Schwäche auf jeder dieser Ebenen kann die spätere Interpretation verändern.
Neun Fragen für Kennzahlen und Diagramme
Redaktionelle Synthese Aus den Buchkapiteln und den ergänzenden Quellen ergibt sich folgende Prüfroutine:
- Welche Population und welcher Zeitraum? Worauf beziehen sich die gezeigten Daten?
- Welche Bezugsgröße? Sind absolute Zahlen, Anteile oder Raten gemeint?
- Welche Verteilung? Was bleibt hinter Mittelwert oder Median verborgen?
- Welche Streuung? Wie unterschiedlich sind die Einzelbeobachtungen?
- Welche ungewöhnlichen Werte? Werden Ausreißer erklärt, geprüft oder still entfernt?
- Welche Aggregation? Welche Gruppen, Zeiträume oder Klassen wurden zusammengefasst?
- Welche visuelle Skala? Verstärkt oder verkleinert die Achsendarstellung den wahrgenommenen Unterschied?
- Welche Unsicherheit? Ist eine Punktschätzung präziser dargestellt, als die Datenlage erlaubt?
- Welche Schlussfolgerung? Ist sie Beschreibung, Interpretation oder bereits eine kausale beziehungsweise normative Behauptung?
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Kritisches Denken in Data Science mit Python , veröffentlichte BookRix-EPUB, insbesondere Kapitel 21 und 22.
Statistik NIST Engineering Statistics Handbook zu Lage, Streuung und Histogrammen.
Visualisierung Office for National Statistics zu Achsenskalierung, Diagrammgestaltung und Unsicherheitsdarstellung.
Technischer Kontext Aktuelle pandas-Dokumentation zur Berechnung absoluter und relativer Häufigkeiten.
Die externen Quellen dienen der statistischen und technischen Präzisierung. Die didaktische Struktur der Wissensseite und die Trennung zwischen Beobachtung und Interpretation stammen aus dem Buch.
Zur allgemeinen redaktionellen Vorgehensweise: Quellen und Arbeitsweise .
Zahlen und Diagramme sind komprimierte Sichtweisen auf Daten
Kritisches Lesen bedeutet nicht, Kennzahlen oder Visualisierungen grundsätzlich zu misstrauen. Es bedeutet, ihre Konstruktion, Bezugsgrößen, Grenzen und den daraus abgeleiteten Erkenntnisanspruch sichtbar zu machen.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.