REPRODUZIERBARKEIT, PIPELINES UND VERSIONIERUNG · FRAGE 10 VON 12
Wie wird aus einem Notebook eine reproduzierbare Data-Science-Pipeline?
Notebooks sind hervorragend für Exploration, Hypothesen und Prototyping. Mit wachsendem Projekt reichen interaktive Einzelabläufe jedoch häufig nicht mehr aus. Reproduzierbare Data Science verlangt definierte Verarbeitungsschritte, konsistente Transformationen, modularen Code sowie nachvollziehbare Daten-, Feature-, Experiment- und Modellversionen.
Kurzantwort: Die veröffentlichte BookRix-EPUB beschreibt den Übergang vom Notebook zur Pipeline als schrittweise Professionalisierung. Explorative Arbeit bleibt im Notebook sinnvoll, während wiederkehrende und produktionsrelevante Schritte in eine definierte Verarbeitungskette überführt werden. Reproduzierbarkeit entsteht, wenn Datenaufbereitung, Features, Modelltraining und Bewertung in konsistenter Reihenfolge ausgeführt, Experimente dokumentiert und Daten-, Feature- und Modellstände miteinander verknüpft werden.
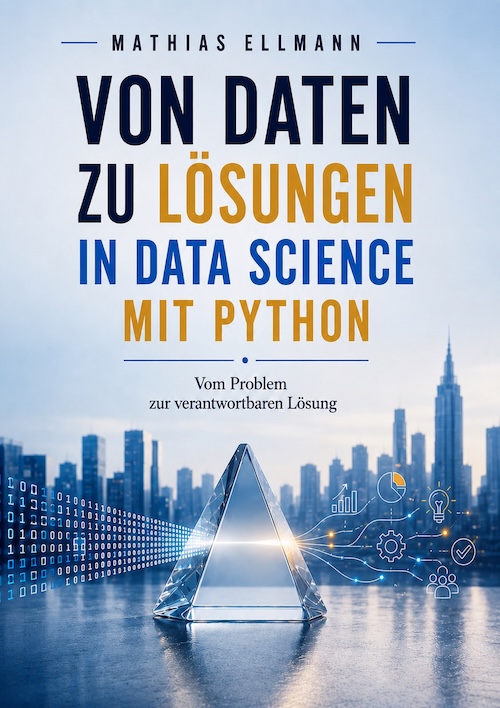
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: Kapitel 33 „Vom Notebook zur Pipeline“, Kapitel 34 „Feature-Pipelines dokumentieren“, Kapitel 35 „Experimente nachvollziehbar machen“ und Kapitel 36 „Modelle versionieren“.
Diese Kapitel behandeln die Grenzen wachsender Notebooks, Reproduzierbarkeit als Ziel, strukturierte Pipeline-Schritte, konsistente Datenvorbereitung, modulare Projektstrukturen, Experimentprotokolle, Datensatz- und Feature-Versionen sowie die Nachvollziehbarkeit von Modellartefakten.
Das Notebook ist ein guter Ausgangspunkt – aber nicht automatisch eine reproduzierbare Lösung
Buchaussage Kapitel 33 der BookRix-EPUB beginnt ausdrücklich mit der Stärke von Jupyter Notebooks. Sie verbinden Code, Ergebnisse, Visualisierungen und Dokumentation und eignen sich deshalb besonders für Exploration, Hypothesentests und erste Modelle.
Mit zunehmender Projektgröße entstehen jedoch typische Probleme: Zellen werden in unterschiedlicher Reihenfolge ausgeführt, Zwischenergebnisse bleiben im Speicher, Variablen werden mehrfach überschrieben, Abhängigkeiten werden unübersichtlich und Code wird kopiert statt wiederverwendet.
Einordnung Das Problem ist damit nicht das Notebook selbst. Kritisch wird es, wenn ein experimenteller Arbeitszustand unbemerkt zur dauerhaften technischen Prozessbeschreibung wird.
Fachlicher Kontext Die BookRix-EPUB ordnet den Übergang zu strukturierten Pipelines in den Kontext professioneller und produktiver Data-Science-Systeme ein. Als fachliche Referenzen werden unter anderem Chip Huyen und Mark Treveil u. a. herangezogen. Der gemeinsame Punkt: Wiederholbare Abläufe und klar definierte Artefakte reduzieren Abhängigkeiten von implizitem Wissen und manuellen Einzelschritten.
Reproduzierbarkeit verlangt eine definierte Verarbeitungskette
Buchaussage Kapitel 33 bezeichnet Reproduzierbarkeit als zentrales Ziel professioneller Data Science. Eine Analyse soll erneut ausgeführt werden können, wobei dieselben Schritte zu vergleichbaren Ergebnissen führen. Dies betrifft insbesondere Datenaufbereitung, Feature Engineering, Modelltraining und Modellbewertung.
Eine Pipeline beschreibt dafür eine fest definierte Abfolge von Verarbeitungsschritten mit klaren Zwecken und Schnittstellen.
- Daten laden: Den benötigten Eingangsdatenstand eindeutig bestimmen.
- Daten vorbereiten: Bereinigung und Transformation reproduzierbar ausführen.
- Features erzeugen: Merkmale mit derselben dokumentierten Logik berechnen.
- Modell trainieren: Training mit definierten Daten und Parametern ausführen.
- Modell bewerten: Ergebnisse mit festgelegten Verfahren und Metriken prüfen.
- Artefakte speichern: Ergebnisse und relevante Modellartefakte nachvollziehbar ablegen.
Einordnung Die Pipeline macht aus einer Folge von Arbeitsgedächtnis und manuellen Klicks einen expliziten Prozess. Reproduzierbarkeit entsteht dadurch nicht automatisch, aber sie wird technisch überprüfbar.
Training und Vorhersage müssen dieselbe Verarbeitung verwenden
Buchaussage Kapitel 33 zeigt mit scikit-learn-Pipelines, wie Transformation und Modell als gemeinsame Verarbeitungseinheit definiert werden können. Training und spätere Vorhersage laufen dadurch über dieselbe Reihenfolge von Schritten.
Das Buch hebt die Bedeutung dieser Konsistenz hervor. Werden Daten im Training anders vorbereitet als bei späteren Vorhersagen, entstehen Risiken durch unterschiedliche Skalierungen, Kategorien, Feature-Berechnungen oder fehlende Transformationen.
Einordnung Die Pipeline ist deshalb mehr als eine bequeme Programmierschnittstelle. Sie kodiert einen Vertrag darüber, welche Verarbeitung zu einem Modell gehört.
Technischer Kontext Die BookRix-EPUB verwendet scikit-learn als Beispiel für strukturierte Pipelines. Pedregosa u. a. werden im Buch als technische Referenz für scikit-learn herangezogen. Entscheidend ist nicht das konkrete Framework, sondern die gemeinsame, reproduzierbare Ausführung von Vorverarbeitung und Modell.
Produktionsrelevanter Code gehört in wiederverwendbare Module
Buchaussage Mit wachsender Projektgröße empfiehlt Kapitel 33, Code aus großen Notebooks auszulagern und die Projektstruktur klarer zu trennen. Als Beispiel nennt das Buch Bereiche für Daten, Notebooks, Quellcode, Modelle, Tests und Berichte.
Notebooks verschwinden dabei nicht. Sie bleiben wertvoll für Exploration, Prototyping, Visualisierung und Dokumentation. Produktionsrelevanter Code soll jedoch möglichst in wiederverwendbaren Modulen liegen.
Einordnung Die Grenze verläuft nicht zwischen „Notebook schlecht“ und „Python-Modul gut“. Entscheidend ist die Funktion: explorative Arbeit darf flexibel sein; wiederkehrende Prozesslogik sollte explizit, testbar und wiederverwendbar werden.
Reproduzierbarkeit umfasst Daten, Features, Experimente und Modellversionen
Buchaussage Kapitel 34 bis 36 erweitern den Pipeline-Gedanken. Eine reproduzierbare Modellversion besteht nicht nur aus einer gespeicherten Modelldatei. Nachvollziehbar bleiben müssen auch Datenherkunft und Datensatzversion, Feature-Berechnung, Hyperparameter, Evaluationsmetriken und Softwareumgebung.
Kapitel 35 fordert für Experimente unter anderem Datensatzversion, verwendete Features, Modelltyp, Hyperparameter, Metriken und Ergebnisse zu dokumentieren. Zufallselemente sollen kontrolliert und auch fehlgeschlagene Experimente festgehalten werden.
Kapitel 36 beschreibt Modellversionen als Kombination aus trainiertem Modell, Datensatzversion, Feature-Version, Hyperparametern, Metriken und Umgebung. Erst dieses Bündel ermöglicht später die Frage zu beantworten, wie eine bestimmte Modellgeneration entstanden ist.
Werkzeugkontext Die BookRix-EPUB nennt unter anderem Git für Quellcode, Joblib für gespeicherte scikit-learn-Modelle und MLflow für Experiment- und Modellverwaltung. Diese Werkzeuge sind Beispiele; die fachliche Anforderung lautet unabhängig davon, dass relevante Stände, Parameter, Metriken und Artefakte eindeutig miteinander verknüpft werden können.
Beispiel: Vom explorativen Notebook zur reproduzierbaren Verarbeitung
Buchbeispiel Der in Kapitel 33 beschriebene Weg lässt sich als schrittweise Professionalisierung verstehen: Exploration und Prototyping bleiben zunächst flexibel; wiederkehrende Verarbeitung wird anschließend strukturiert, automatisiert und versioniert.
| Explorativer Zustand | Reproduzierbare Form | Gewonnene Eigenschaft |
|---|---|---|
| Zellen laden und verändern Daten manuell. | Explizite Lade- und Transformationsfunktionen. | Wiederholbarkeit |
| Feature-Code ist zwischen Analysezellen verteilt. | Definierte Feature-Pipeline. | Konsistenz |
| Modellparameter stehen nur im Notebook. | Parameter und Experimentkontext werden protokolliert. | Nachvollziehbarkeit |
| Ein trainiertes Modell wird lokal überschrieben. | Modellartefakt und Metadaten erhalten eine Version. | Vergleichbarkeit |
| Der Ablauf hängt von manuellen Schritten ab. | Pipeline führt definierte Schritte in festgelegter Reihenfolge aus. | Automatisierbarkeit |
Einordnung Nicht jede Analyse benötigt sofort eine umfangreiche Infrastruktur. Der entscheidende Fortschritt besteht darin, implizite Arbeitsschritte schrittweise in explizite, überprüfbare Projektbestandteile zu überführen.
Sieben Prüffragen für eine reproduzierbare Data-Science-Pipeline
Redaktionelle Synthese Aus den Kapiteln 33 bis 36 lässt sich folgende Prüfreihenfolge ableiten. Sie ist kein MLOps-Reifegradmodell und nimmt die kontinuierliche Überwachung der nächsten Wissensseite nicht vorweg.
- Eingangsdaten: Ist eindeutig, welche Daten- und Versionsstände die Pipeline verarbeitet?
- Verarbeitung: Sind Bereinigung, Transformation und Feature Engineering als reproduzierbarer Code definiert?
- Konsistenz: Verwenden Training und Vorhersage dieselbe Verarbeitungskette?
- Modularität: Liegt wiederkehrende Prozesslogik außerhalb explorativer Notebook-Zellen in wiederverwendbaren Komponenten?
- Experimentkontext: Sind Daten, Features, Parameter, Zufallszustände, Metriken und Ergebnisse dokumentiert?
- Modellversion: Lassen sich Modellartefakt, Datensatz-, Feature- und Codeversion eindeutig miteinander verbinden?
- Wiederholung: Kann ein anderer Projektbeteiligter den Ablauf mit dokumentierten Eingaben erneut durchführen und vergleichbare Ergebnisse erzeugen?
Eine Pipeline ist damit reproduzierbar, wenn nicht nur der Code vorhanden ist, sondern auch der benötigte Kontext des erzeugten Ergebnisses nachvollziehbar bleibt.
Wo die Aussage bewusst endet
Eine reproduzierbare Pipeline garantiert noch keinen dauerhaft erfolgreichen produktiven Betrieb. Auch ein sauber versioniertes Modell kann an Qualität verlieren, wenn sich Eingabedaten, Prozesse oder reale Zusammenhänge verändern.
Diese Seite behandelt deshalb bewusst noch nicht die laufende Überwachung von Datenqualität, Modellleistung, Daten-Drift, Concept Drift und realer Wirkung. Diese Themen gehören zur nächsten Fachfrage.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere Kapitel 33 „Vom Notebook zur Pipeline“, Kapitel 34 „Feature-Pipelines dokumentieren“, Kapitel 35 „Experimente nachvollziehbar machen“ und Kapitel 36 „Modelle versionieren“.
Produktions- und Pipeline-Kontext Die Buchgrundlage verweist unter anderem auf Chip Huyen, Designing Machine Learning Systems, Mark Treveil u. a., Introducing MLOps, sowie auf scikit-learn und MLflow als technische Kontexte für reproduzierbare und nachvollziehbare ML-Arbeit.
Redaktionelle Einordnung Werkzeuge wie Git, Joblib, scikit-learn-Pipelines oder MLflow sind hier Beispiele. Der Qualitätskern liegt in expliziten Verarbeitungsschritten, dokumentierten Experimenten sowie eindeutig zuordenbaren Daten-, Feature-, Code- und Modellständen.
Die konkrete technische Architektur hängt von Projektgröße, Team, Datenvolumen, Wiederholungsfrequenz und Betriebsanforderungen ab. Ein kleines Projekt kann reproduzierbar sein, ohne eine umfangreiche Plattform einzusetzen.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.