MONITORING, DRIFT UND KONTINUIERLICHES LERNEN · FRAGE 11 VON 12
Wie überwacht man Modelle, Daten-Drift und Lernen im Betrieb?
Die Einführung eines Modells beendet das Data-Science-Projekt nicht. Daten, Prozesse und reale Zusammenhänge verändern sich. Deshalb müssen Eingabedaten, Vorhersagen, Modellqualität und technische Signale beobachtet, Veränderungen eingeordnet und Erkenntnisse aus dem Betrieb wieder in Datenaufbereitung, Features, Modellierung und Evaluation zurückgeführt werden.
Kurzantwort: Die veröffentlichte BookRix-EPUB beschreibt Monitoring als systematische Überwachung eines laufenden Machine-Learning-Systems. Beobachtet werden unter anderem Eingabedaten, Vorhersagen, Qualitätsmetriken, Laufzeiten und Fehler. Data Drift bezeichnet veränderte Eingabeverteilungen; Concept Drift eine Veränderung des Zusammenhangs zwischen Eingaben und Zielvariable. Monitoring soll solche Veränderungen früh sichtbar machen. Aus Analyse, Feedback, Verbesserung und gegebenenfalls Neu-Training entsteht anschließend ein kontinuierlicher Lernkreislauf.
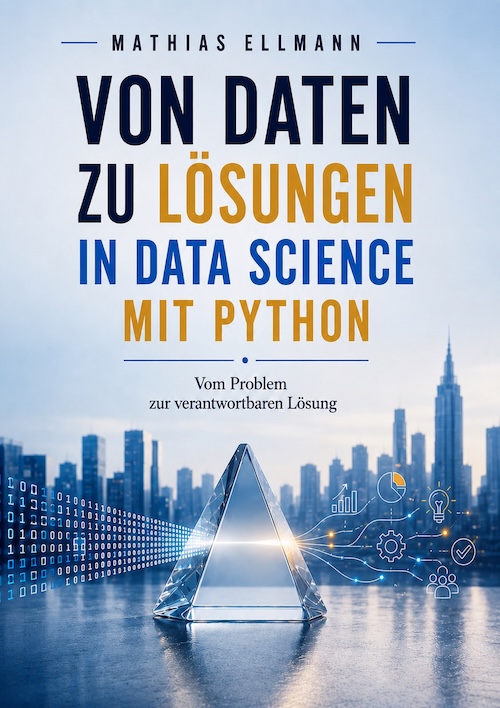
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: Kapitel 37 „Monitoring und Daten-Drift“ sowie Kapitel 38 „Lernen aus der Umsetzung“.
Kapitel 37 behandelt die Überwachung von Eingabedaten, Modellvorhersagen und Qualitätsmetriken, Data Drift, Concept Drift, Prediction Drift, Alarmgrenzen, Dashboards und Retraining. Kapitel 38 erweitert diese Perspektive um Feedback aus der realen Umsetzung, kontinuierliche Verbesserung, neue Features, Modellweiterentwicklung, technische Verbesserungen und dokumentiertes Lernen.
Nach dem Deployment beginnt die Phase der Überwachung
Buchaussage Kapitel 37 der BookRix-EPUB beginnt mit einer klaren Aussage: Die Entwicklung eines Modells ist nicht das Ende eines Data-Science-Projekts. Ein Modell kann beim Training sehr gute Ergebnisse erzielen und später trotzdem an Qualität verlieren, weil sich Daten oder Rahmenbedingungen verändern.
Als Beispiele nennt das Buch veränderte Kundengruppen, neue Produkte, saisonale Effekte, geänderte Geschäftsprozesse und technische Probleme. Solche Veränderungen können ein weiterhin technisch laufendes Modell fachlich schlechter machen.
- Beobachten: Daten, Vorhersagen, Qualitätskennzahlen und technische Signale kontinuierlich erfassen.
- Abweichung erkennen: Veränderungen gegenüber bekannten oder erwarteten Zuständen sichtbar machen.
- Ursache analysieren: Datenproblem, Modellproblem, Prozessänderung oder technisches Problem unterscheiden.
- Maßnahme wählen: Alarm, Datenkorrektur, Prozessanpassung, Retraining oder weitere Analyse begründen.
- Lernen: Erkenntnisse dokumentieren und in den nächsten Entwicklungszyklus zurückführen.
Einordnung Monitoring ist damit kein nachträglicher Kontrollschritt, sondern Teil des Lebenszyklus einer Data-Science-Lösung. Die zentrale Frage lautet: Gilt unter heutigen Bedingungen noch das, was während Entwicklung und Evaluation angenommen wurde?
Fachlicher Kontext Die BookRix-EPUB verweist im Produktionskontext unter anderem auf Chip Huyen, Designing Machine Learning Systems, und Mark Treveil u. a., Introducing MLOps. Im Buch stützen diese Referenzen die Einordnung, dass Modellbetrieb als fortlaufender Prozess aus Überwachung, Analyse und Verbesserung verstanden werden muss.
Monitoring muss Daten, Vorhersagen, Qualität und Technik verbinden
Buchaussage Abschnitt 37.2 beschreibt Monitoring als systematische Überwachung eines laufenden Systems. Im Machine-Learning-Kontext nennt die EPUB Eingabedaten, Modellvorhersagen, Qualitätsmetriken, Laufzeiten und Fehlermeldungen.
Kapitel 37 ergänzt die Beobachtung von Wertebereichen, Datenverteilungen, fehlenden Werten und neuen Kategorien. Auch die Verteilung der Vorhersagen selbst kann wichtige Hinweise liefern, etwa wenn plötzlich deutlich mehr positive Fälle entstehen oder ungewöhnliche Muster auftreten.
Einordnung Ein einzelner Modellscore reicht deshalb nicht. Ein Qualitätsabfall kann seine Ursache bereits in den Eingabedaten haben; ein technischer Fehler kann Vorhersagen verändern, ohne dass sich das fachliche Konzept geändert hat.
Data Drift, Concept Drift und Prediction Drift beschreiben unterschiedliche Veränderungen
Buchaussage Kapitel 37 unterscheidet mehrere Driftformen. Data Drift bedeutet, dass sich die Verteilung der Eingabedaten verändert. Concept Drift bedeutet, dass sich der Zusammenhang zwischen Eingabedaten und Zielvariable verändert. Prediction Drift beschreibt eine auffällige Veränderung der Modellvorhersagen.
Das Buch illustriert Data Drift mit einem Kreditmodell: Wurde es ursprünglich für Kundinnen und Kunden mit einem Durchschnittsalter von 45 Jahren trainiert und wird später verstärkt von deutlich jüngeren Personen genutzt, hat sich die Eingabeverteilung verändert.
Concept Drift ist subtiler. Die Datenstruktur kann ähnlich aussehen, während ein früher relevanter Zusammenhang seine Bedeutung verliert, beispielsweise nach einer Marktveränderung.
| Driftform | Was verändert sich? | Typische Prüffrage |
|---|---|---|
| Data Drift | Verteilung der Eingabedaten | Sehen die aktuellen Eingaben noch aus wie die Trainingsdaten? |
| Concept Drift | Zusammenhang zwischen Eingaben und Zielvariable | Gelten die früher gelernten Beziehungen in der Realität noch? |
| Prediction Drift | Verteilung der Modellvorhersagen | Erzeugt das Modell plötzlich andere Score- oder Klassenverteilungen? |
Einordnung Drift ist zunächst ein Diagnosehinweis. Eine veränderte Verteilung beweist noch nicht automatisch, dass ein Modell ersetzt werden muss. Entscheidend ist, ob die Veränderung relevant ist und welche Auswirkungen sie auf Qualität und Entscheidung besitzt.
Alarmgrenzen und Dashboards machen Veränderungen handhabbar
Buchaussage Kapitel 37 empfiehlt, Monitoring möglichst zu automatisieren. Dafür können Schwellenwerte definiert werden, etwa für zu niedrige Modellqualität, einen zu hohen Anteil fehlender Werte oder neu auftretende Kategorien. Beim Überschreiten eines Grenzwerts kann ein Alarm ausgelöst werden.
Dashboards können Modellleistung, Datenqualität, Drift-Indikatoren und Systemauslastung kontinuierlich sichtbar machen. Ihr Zweck besteht nicht nur in Visualisierung, sondern darin, Abweichungen früh erkennbar und analysierbar zu machen.
Einordnung Ein Alarm ist noch keine Entscheidung. Zu enge Grenzen erzeugen unnötige Warnungen; zu weite Grenzen lassen relevante Veränderungen unentdeckt. Grenzwerte brauchen deshalb einen fachlichen Bezug zu Risiko und Handlung.
Technischer Kontext Die BookRix-EPUB ordnet Monitoring als Bestandteil von MLOps ein. Der Lebenszyklus wird dort als Kreislauf aus Überwachung, Analyse, Verbesserung und Neu-Training beschrieben. Technische Werkzeuge können Kennzahlen sammeln und visualisieren; die Interpretation der Signale bleibt eine fachliche Aufgabe.
Retraining ist eine mögliche Reaktion – nicht die automatische Antwort auf jede Drift
Buchaussage Abschnitt 37.16 stellt ausdrücklich klar, dass nicht jede Drift sofortiges Handeln verlangt. Sinkt die Modellqualität jedoch deutlich, kann ein erneutes Training mit aktuelleren Daten erforderlich sein.
Vor einem Retraining sollte geklärt werden, welche Veränderung tatsächlich vorliegt. Neue Trainingsdaten helfen nicht gegen jede technische Störung, falsche Eingabefelder oder ungeeignete Prozesslogik. Ebenso kann eine Prozessänderung verlangen, die Fragestellung oder Zielvariable neu zu betrachten statt nur dasselbe Modell erneut zu trainieren.
Einordnung Retraining ist damit eine begründete Maßnahme innerhalb eines Diagnoseprozesses. Ein automatischer Zeitplan allein garantiert keine bessere Lösung.
Die Umsetzung wird zum Realitätstest und zum Lernprozess
Buchaussage Kapitel 38 erweitert das Monitoring um das Lernen aus der Umsetzung. Viele Annahmen über Daten, Features, Modelle und Kennzahlen werden erst im realen Einsatz vollständig überprüfbar. Fehler, Feedback und neue Beobachtungen erzeugen deshalb Wissen, das in den Projektzyklus zurückfließen soll.
Die EPUB beschreibt professionelle Data Science als Lernkreislauf. Neue Erkenntnisse können Änderungen an Datensammlung, Datenaufbereitung, Feature Engineering, Modellierung und Evaluation auslösen. Auch technische Prozesse wie ETL, Datenvalidierung, Tests, Dokumentation und Deployment können verbessert werden.
Einordnung Lernen im Betrieb bedeutet deshalb mehr als regelmäßiges Retraining. Die gesamte Lösung wird aufgrund realer Evidenz weiterentwickelt.
Sieben Prüffragen für Monitoring, Drift und Lernen im Betrieb
Redaktionelle Synthese Aus den Kapiteln 37 und 38 der BookRix-EPUB lässt sich folgende Prüfreihenfolge ableiten. Sie ersetzt keine projektspezifische Betriebs- oder Incident-Architektur.
- Signale: Welche Eingabedaten, Vorhersagen, Qualitätsmetriken und technischen Kennzahlen müssen beobachtet werden?
- Referenz: Gegen welchen Trainings-, Validierungs- oder bisherigen Produktionszustand werden Veränderungen bewertet?
- Driftart: Liegt eine Veränderung der Eingaben, der Vorhersagen oder des realen Zusammenhangs mit der Zielvariable vor?
- Alarmgrenze: Ab welcher Veränderung besteht tatsächlich Analyse- oder Handlungsbedarf?
- Ursache: Ist das Problem durch Daten, Modell, Technik oder einen veränderten Prozess entstanden?
- Maßnahme: Ist Beobachtung, Korrektur, Retraining, Feature-Anpassung oder eine grundlegende Neubewertung sinnvoll?
- Lernschleife: Werden Erkenntnisse, Maßnahmen und Ergebnisse dokumentiert und in zukünftige Projektentscheidungen zurückgeführt?
Monitoring wird damit erst dann zum Lernen, wenn beobachtete Veränderungen zu nachvollziehbaren Erkenntnissen und begründeten Verbesserungen führen.
Wo die Aussage bewusst endet
Monitoring garantiert nicht, dass jede relevante Veränderung sofort erkannt wird. Manche Zielgrößen stehen erst spät zur Verfügung, Concept Drift kann schwer messbar sein und Alarmgrenzen können Fehlalarme oder übersehene Probleme erzeugen.
Ebenso entscheidet Monitoring noch nicht automatisch, welche Handlung fachlich oder organisatorisch verantwortbar ist. Die Übersetzung von Ergebnissen, Risiken und Unsicherheit in nachvollziehbare Empfehlungen und Entscheidungen ist Gegenstand der letzten Wissensseite.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere Kapitel 37 „Monitoring und Daten-Drift“ und Kapitel 38 „Lernen aus der Umsetzung“.
Monitoring und MLOps Die Buchgrundlage verweist im Kontext produktiver Machine-Learning-Systeme unter anderem auf Chip Huyen, Designing Machine Learning Systems, und Mark Treveil u. a., Introducing MLOps.
Redaktionelle Einordnung Drift-Indikatoren und Alarmgrenzen sind Diagnoseinstrumente. Sie ersetzen weder Ursachenanalyse noch eine fachliche Entscheidung über Retraining, Prozessänderung oder weitere Maßnahmen.
Welche Kennzahlen, Referenzzeiträume und Alarmgrenzen geeignet sind, hängt von Daten, Entscheidungstakt, Verfügbarkeit der Zielwerte und den möglichen Folgen eines Qualitätsverlusts ab.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.