FEATURE ENGINEERING, FACHWISSEN UND MERKMALE · FRAGE 4 VON 12
Wie entwickelt man aus Rohdaten fachlich sinnvolle Features?
Features entstehen nicht dadurch, dass möglichst viele zusätzliche Spalten berechnet werden. Fachlich sinnvolle Merkmale übersetzen Problemverständnis, Domänenwissen und Rohdaten in Informationen, die eine konkrete Fragestellung unterstützen und von Analysen oder Modellen genutzt werden können.
Kurzantwort: Die veröffentlichte BookRix-EPUB versteht Feature Engineering als Brücke zwischen Datenaufbereitung und Modellierung. Ausgangspunkt ist nicht Python, sondern die Frage, welche Informationen helfen könnten, ein Problem besser zu verstehen oder vorherzusagen. Aus Rohdaten entstehen dann beispielsweise Zeitdifferenzen, Verhältnisse, Aggregationen, Vergleiche oder fachlich begründete Kennzahlen. Python setzt diese Ideen reproduzierbar um; den fachlichen Sinn liefert es nicht automatisch.
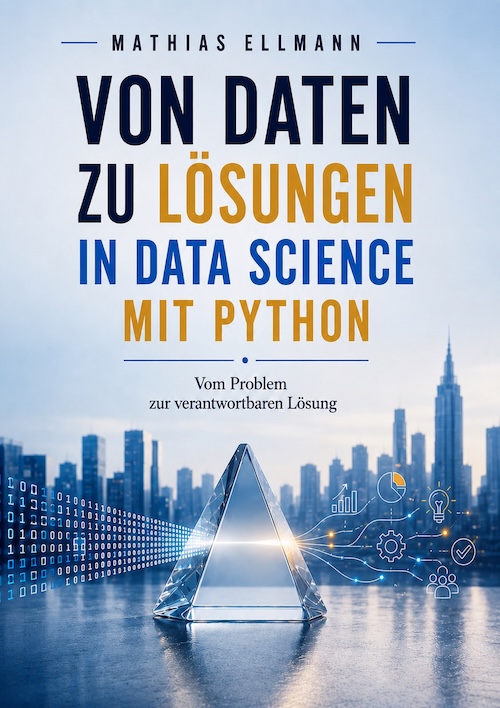
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: Kapitel 4 „Features entwickeln“, hier 4.1 „Was Feature Engineering leistet“, 4.2 „Von Rohdaten zu Merkmalen“, 4.3 „Feature-Ideen entwickeln“ und 4.4 „Features mit Python erzeugen“.
Diese Abschnitte verbinden fachliche Fragestellung, Domänenwissen und technische Umsetzung. Sie zeigen, wie aus operativen Rohdaten Merkmale entstehen, warum Feature-Ideen begründet werden müssen und wie pandas, NumPy und scikit-learn ihre reproduzierbare Berechnung unterstützen.
Feature Engineering übersetzt Problemverständnis in nutzbare Merkmale
Buchaussage Abschnitt 4.1 der BookRix-EPUB beschreibt Feature Engineering als Entwicklung von Merkmalen, die Zusammenhänge sichtbar und für Machine-Learning-Modelle nutzbar machen. Die zentrale Frage lautet nicht: „Welche zusätzliche Spalte können wir erzeugen?“, sondern: „Welche Informationen benötigt das Modell, um die Fragestellung möglichst gut beantworten zu können?“
Die Antwort ergibt sich laut Buch nicht allein aus den vorhandenen Daten. Sie verlangt fachliches Verständnis, Kreativität und analytisches Denken. Damit verbindet Feature Engineering technische Datenverarbeitung mit der ursprünglichen Problemstellung.
Einordnung Ein Feature ist deshalb mehr als eine mathematische Transformation. Es enthält eine Annahme darüber, welche Eigenschaft eines realen Sachverhalts für die Aufgabe relevant sein könnte. Diese Annahme sollte fachlich erklärbar bleiben.
Fachlicher Kontext Die BookRix-EPUB verweist hierzu auf Max Kuhn und Kjell Johnson, Feature Engineering and Selection (2019), sowie auf Hastie, Tibshirani und Friedman, The Elements of Statistical Learning (2009). Im Buch stützen diese Referenzen die Einordnung, dass die Wahl und Gestaltung von Merkmalen einen wesentlichen Einfluss auf Modellierung und Interpretation besitzt.
Von Rohdaten zu Merkmalen heißt: Information verdichten
Buchaussage Abschnitt 4.2 zeigt, dass Rohdaten häufig für operative Zwecke entstanden sind und nicht unmittelbar die Form besitzen, die eine Analyse benötigt. Aus einem Geburtsdatum kann das Alter entstehen, aus einem Vertragsbeginn die Vertragsdauer, aus vielen Käufen eine Kaufhäufigkeit und aus Login-Zeitpunkten die Zeit seit der letzten Aktivität.
Diese Ableitungen verändern die Perspektive auf die Daten. Einzelne Ereignisse oder Felder werden zu verdichteten Informationen, die einen möglichen Zusammenhang mit der Fragestellung ausdrücken.
Einordnung Verdichtung ist keine neutrale Operation. Wer aus einem Vertragsbeginn eine Vertragsdauer oder aus Transaktionen einen Durchschnittsumsatz bildet, entscheidet zugleich, welche Information hervorgehoben und welche Detailinformation zurückgenommen wird.
Gute Feature-Ideen beginnen bei Fragestellung und Domänenwissen
Buchaussage Abschnitt 4.3 stellt eine einfache Leitfrage in den Mittelpunkt: Welche Informationen könnten helfen, das Problem besser zu verstehen oder vorherzusagen? Feature Engineering beginnt dort ausdrücklich mit Nachdenken und nicht mit Python.
- Fragestellung klären: Welche Entscheidung oder Vorhersage soll das Merkmal unterstützen?
- Fachwissen einbeziehen: Welche Faktoren gelten im jeweiligen Domänenkontext als relevant?
- Rohdaten prüfen: Welche vorhandenen Felder oder Ereignisse enthalten dafür nutzbare Information?
- Hypothese formulieren: Warum könnte das neue Merkmal einen Zusammenhang sichtbar machen?
- Berechnung definieren: Wie lässt sich die Idee nachvollziehbar aus verfügbaren Daten erzeugen?
Einordnung Fachexpertinnen und Fachexperten kennen oft Kennzahlen, Prozessschritte oder typische Muster, die in einem Rohdatensatz nicht als fertige Spalte vorliegen. Feature Engineering wird dadurch zu einer Zusammenarbeit zwischen Daten, Methoden und Domänenwissen.
Verhältnisse, Zeit, Aggregationen und Vergleiche schaffen neue Perspektiven
Buchaussage Die Abschnitte 4.1 bis 4.4 nennen wiederkehrende Muster für neue Features. Dazu gehören Verhältnisse wie Umsatz pro Bestellung, Zeitmerkmale wie Vertragsdauer oder Tage seit der letzten Aktivität, Aggregationen wie Anzahl oder Durchschnitt von Ereignissen sowie Vergleiche mit Gruppen, früheren Zeiträumen oder historischen Werten.
Solche Merkmale können Rohdaten vergleichbarer machen oder Entwicklungen sichtbar machen, die in absoluten Einzelwerten verborgen bleiben. Ein Kunde mit hohem Gesamtumsatz kann beispielsweise wenig aktiv sein, wenn dieser Umsatz über einen sehr langen Zeitraum entstanden ist. Ein Verhältnis oder Zeitbezug kann diese Information anders darstellen.
Einordnung Typische Muster sind Ideenquellen, keine Automatismen. Ob ein Verhältnis, eine Aggregation oder ein Zeitfenster fachlich sinnvoll ist, hängt von der Fragestellung und der Bedeutung der zugrunde liegenden Daten ab.
Beispiel: Kundenabwanderung aus Verhaltensmerkmalen beschreiben
Buchbeispiel Abschnitt 4.3 verwendet Kundenabwanderung als Beispiel. Aus Vertragsbeginn, Käufen, Supportkontakten, Login-Aktivitäten und Umsatzdaten können Merkmale wie Vertragsdauer, Käufe pro Monat, Tage seit letztem Login, Anzahl Supportkontakte oder Umsatzentwicklung entstehen.
| Rohdaten | Mögliches Feature | Fachliche Hypothese |
|---|---|---|
| Vertragsbeginn | Vertragsdauer | Die Dauer der Kundenbeziehung kann Bindung oder Erfahrung mit dem Angebot ausdrücken. |
| Kaufhistorie | Käufe pro Monat | Eine relative Kaufhäufigkeit kann Aktivität besser beschreiben als eine reine Gesamtzahl. |
| Login-Zeitpunkte | Tage seit letztem Login | Längere Inaktivität kann auf sinkendes Engagement hinweisen. |
| Supportkontakte | Anzahl Kontakte in einem Zeitraum | Häufige Probleme oder Rückfragen können für die Kundenbeziehung relevant sein. |
| Umsatzhistorie | Umsatzentwicklung | Eine Veränderung über die Zeit kann mehr Information enthalten als ein einzelner Gesamtwert. |
Einordnung Diese Merkmale sind zunächst Hypothesen in Datenform. Ihre fachliche Plausibilität rechtfertigt, sie zu untersuchen; sie beweist noch nicht, dass sie für ein späteres Modell tatsächlich nützlich sind.
Python setzt Feature-Ideen um – es erzeugt ihren fachlichen Sinn nicht
Buchaussage Abschnitt 4.4 zeigt typische technische Umsetzungen mit pandas, NumPy und scikit-learn: Zeitmerkmale ableiten, Verhältnisse berechnen, Transaktionen aggregieren, Kategorien codieren, Texte in einfache Kennzahlen überführen, logarithmische Transformationen anwenden, Interaktionen erzeugen oder Features skalieren.
Die EPUB trennt dabei Idee und Implementierung. Python kann beispielsweise kaeufe_pro_monat, vertragsdauer_tage oder umsatz_pro_bestellung zuverlässig berechnen. Warum gerade diese Kennzahl für das Problem sinnvoll sein könnte, muss aber fachlich begründet werden.
Technischer Kontext Für die Umsetzung verweist die BookRix-EPUB unter anderem auf Wes McKinney, Python for Data Analysis (3. Auflage, 2022), Fabian Pedregosa u. a., „Scikit-learn: Machine Learning in Python“ (2011), sowie Aurélien Géron, Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow (3. Auflage, 2022). Sie dienen im Buch als technische Referenzen für Datenmanipulation, Transformation und reproduzierbare Modellierung.
Sieben Prüffragen für fachlich sinnvolle Features
Redaktionelle Synthese Aus den Abschnitten 4.1 bis 4.4 der BookRix-EPUB lässt sich folgende Prüfreihenfolge ableiten. Sie ist kein validierter Feature-Selection-Standard und nimmt die detaillierte Qualitäts- und Leakage-Prüfung der nächsten Wissensseite nicht vorweg.
- Problembezug: Welchen Teil der Fragestellung oder Entscheidung soll das Feature besser abbilden?
- Fachlicher Sinn: Welche plausible Annahme verbindet das Merkmal mit dem realen Sachverhalt?
- Datenbasis: Aus welchen Rohdaten wird das Feature berechnet und sind deren Bedeutungen verstanden?
- Berechnung: Ist die Transformationslogik eindeutig, nachvollziehbar und reproduzierbar?
- Verdichtung: Welche Information wird hervorgehoben und welche geht durch Aggregation oder Transformation verloren?
- Interpretierbarkeit: Lässt sich erklären, was ein hoher, niedriger oder veränderter Feature-Wert fachlich bedeutet?
- Dokumentation: Sind Name, Datenquellen, Berechnungslogik, fachliche Bedeutung und Zeitpunkt der Verfügbarkeit festgehalten?
Ein Feature ist damit nicht schon deshalb gut, weil es technisch berechnet werden kann. Es sollte eine nachvollziehbare Brücke zwischen Rohdaten und Problemverständnis bilden.
Wo die Aussage bewusst endet
Fachliche Plausibilität allein beweist noch keine Feature-Qualität. Ein sinnvoll erscheinendes Merkmal kann instabil, redundant, fehlerhaft berechnet oder für die spätere Vorhersagesituation ungeeignet sein. Auch viele zusätzliche Features verbessern ein Modell nicht automatisch und können Komplexität, Rauschen oder Überanpassung erhöhen.
Besonders die Frage, ob eine Information zum tatsächlichen Vorhersagezeitpunkt verfügbar wäre, wird auf dieser Seite nur als Grenze markiert. Die systematische Bewertung von Feature-Qualität und Datenleckage ist Gegenstand der nächsten Fachfrage.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere 4.1 bis 4.4.
Feature Engineering Max Kuhn und Kjell Johnson (2019): Feature Engineering and Selection: A Practical Approach for Predictive Models. CRC Press; Trevor Hastie, Robert Tibshirani und Jerome Friedman (2009): The Elements of Statistical Learning. 2. Auflage, Springer.
Python und Machine Learning Wes McKinney (2022): Python for Data Analysis. 3. Auflage, O’Reilly Media; Fabian Pedregosa, Gaël Varoquaux, Alexandre Gramfort u. a. (2011): „Scikit-learn: Machine Learning in Python“, Journal of Machine Learning Research 12, 2825–2830; Aurélien Géron (2022): Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3. Auflage, O’Reilly Media.
Die externen Quellen werden hier nur in dem Umfang eingeordnet, in dem sie in der veröffentlichten BookRix-EPUB als fachlicher oder technischer Kontext verwendet werden. Die konkrete Eignung eines Features muss anschließend empirisch und im Projektkontext geprüft werden.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.