FEATURE-QUALITÄT, STABILITÄT UND DATENLECKAGE · FRAGE 5 VON 12
Wie bewertet man Feature-Qualität und vermeidet Datenleckage?
Ein Feature ist nicht automatisch gut, nur weil es mit der Zielgröße zusammenhängt oder ein Modell verbessert. Belastbare Merkmale müssen fachlich sinnvoll, reproduzierbar, stabil und im späteren Einsatz tatsächlich verfügbar sein. Besonders kritisch ist Datenleckage: Informationen aus der Zukunft können Modelle künstlich stark erscheinen lassen.
Kurzantwort: Die veröffentlichte BookRix-EPUB bewertet Feature-Qualität mehrdimensional: fachliche Relevanz, ausreichende Variation, Datenqualität, Zusammenhang mit der Zielgröße, Stabilität, Interpretierbarkeit und reproduzierbare Berechnung gehören zusammen. Das wichtigste Leakage-Kriterium lautet: Wäre diese Information zum Zeitpunkt der Vorhersage tatsächlich verfügbar gewesen? Wenn nicht, entsteht ein unrealistisch günstiges Modellbild, das im produktiven Einsatz nicht reproduzierbar ist.
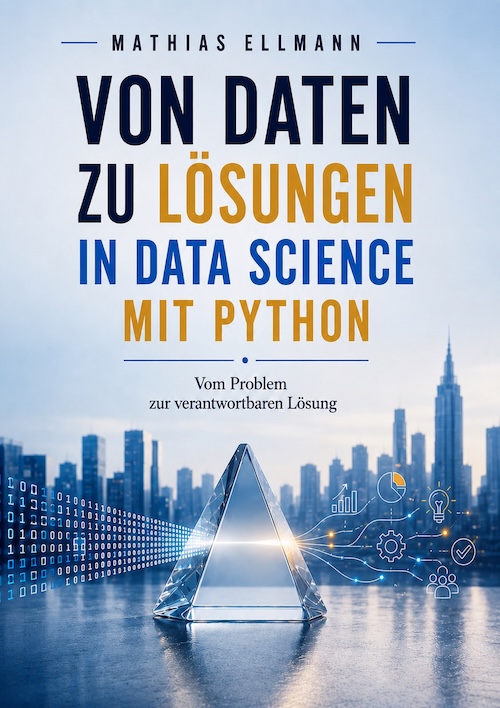
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: 4.5 „Feature-Qualität bewerten“ und 4.6 „Datenleckage und Feature-Risiken“.
Diese Abschnitte verbinden fachliche Bewertung, statistische Diagnose und produktive Verfügbarkeit. Sie behandeln unter anderem Variation, fehlende Werte, Redundanz, Stabilität, Feature-Wichtigkeit, Feature-Selektion, Datenleckage durch Zukunftsinformationen, Aggregationen, Datenzusammenführungen und Vorverarbeitung sowie Risiken im Produktivbetrieb.
Feature-Qualität ist mehrdimensional
Buchaussage Abschnitt 4.5 der BookRix-EPUB betont, dass nicht jedes erzeugte Feature eine Analyse oder ein Modell verbessert. Ein hochwertiges Merkmal soll fachlich sinnvoll sein, relevante Information enthalten, zuverlässig und reproduzierbar berechnet werden können und möglichst wenig Rauschen enthalten.
Die Qualität ergibt sich damit nicht aus einer einzelnen Statistik. Fachliche Plausibilität, Datenqualität, Variation, Zusammenhang mit der Zielgröße, Stabilität und Interpretierbarkeit müssen gemeinsam betrachtet werden.
Einordnung Ein Feature kann statistisch auffällig und trotzdem ungeeignet sein. Umgekehrt kann ein fachlich plausibles Merkmal zu wenig Variation besitzen oder im Betrieb nicht stabil erzeugt werden. Feature-Qualität ist deshalb immer eine Kombination aus Informationsgehalt, technischer Verlässlichkeit und Einsatzkontext.
Fachlicher Kontext Die BookRix-EPUB verweist für Feature Engineering und Auswahl unter anderem auf Max Kuhn und Kjell Johnson, Feature Engineering and Selection (2019), sowie auf Hastie, Tibshirani und Friedman, The Elements of Statistical Learning (2009). Im Buch stützen diese Referenzen die systematische Bewertung und Auswahl von Merkmalen.
Fachliche Relevanz und statistische Diagnose müssen zusammenarbeiten
Buchaussage Abschnitt 4.5 beginnt die Bewertung mit einer fachlichen Frage: Warum sollte dieses Merkmal überhaupt mit der Zielgröße zusammenhängen? Erst danach folgen statistische Prüfungen wie Verteilungen, Kategorien, fehlende Werte, Korrelationen, Gruppenvergleiche oder modellabhängige Feature-Wichtigkeiten.
Ein Merkmal mit fast identischen Werten liefert häufig wenig zusätzliche Information. Sehr viele seltene Kategorien, inkonsistente Schreibweisen oder ein hoher Anteil fehlender Werte können die Nutzbarkeit einschränken. Auch starke Korrelationen sind nur Hinweise und keine automatische Begründung für fachliche Relevanz.
Einordnung Das schützt vor zwei gegensätzlichen Fehlern: rein fachliche Intuition ohne Datenprüfung und rein statistische Auswahl ohne Problemverständnis. Belastbare Feature-Bewertung verbindet beide Perspektiven.
Redundanz, Stabilität und Produktionsfähigkeit gehören zur Qualitätsprüfung
Buchaussage Die EPUB weist darauf hin, dass mehrere Features nahezu dieselbe Information enthalten können. Alter in Jahren und Alter in Monaten beschreiben beispielsweise im Wesentlichen denselben Sachverhalt. Redundante Merkmale erhöhen die Komplexität, ohne zwingend zusätzlichen Nutzen zu liefern.
Ebenso wichtig ist Stabilität: Bleibt die Verteilung bei neuen Daten ähnlich? Kann das Feature langfristig berechnet werden? Ändert sich seine Bedeutung über die Zeit? Und lässt es sich im Produktivbetrieb überhaupt zuverlässig erzeugen?
Einordnung Ein Feature ist nicht nur eine Spalte im Trainingsdatensatz, sondern ein dauerhaft zu erzeugendes Informationsprodukt. Damit werden Datenquelle, Berechnungslogik und betriebliche Verfügbarkeit zu Bestandteilen seiner Qualität.
Datenleckage erzeugt künstlich gute Modelle
Buchaussage Abschnitt 4.6 definiert Datenleckage als Nutzung von Informationen, die zum Zeitpunkt der Vorhersage in der Praxis noch nicht verfügbar wären. Das Modell erhält dadurch einen unfairen Informationsvorteil. Im Training erscheinen die Ergebnisse außergewöhnlich gut; im realen Einsatz fehlt diese Information und die Leistung bricht ein.
Die BookRix-EPUB nennt als typische Ursachen Zukunftsinformationen, nachträglich berechnete Kennzahlen, fehlerhafte Datenzusammenführungen, Zielinformationen in Features und falsche Zeitbezüge.
Externe Evidenz Im Leakage-Kontext verweist die EPUB unter anderem auf Aurélien Géron (2022), Chip Huyen (2022) und Sculley u. a. (2015). Sie dienen dort als fachlicher Kontext für unrealistisch gute Offline-Ergebnisse, Produktionsrisiken und technische Schulden in Machine-Learning-Systemen.
Die wichtigste Leakage-Frage betrifft den Vorhersagezeitpunkt
Buchaussage Die zentrale Prüffrage der EPUB lautet: Wäre diese Information zum Zeitpunkt der Vorhersage tatsächlich verfügbar gewesen? Ist die Antwort nein, liegt wahrscheinlich Datenleckage vor.
Beim Kündigungsbeispiel wäre ein Kündigungsdatum offensichtlich unzulässig, weil es die spätere Zielinformation bereits enthält. Weniger offensichtliche Leckagen entstehen etwa durch Beschwerden, die erst nach einem Ereignis eingehen, durch Jahresaggregationen mit zukünftigen Monaten oder durch spätere Bearbeitungsvermerke und finale Prozessergebnisse.
- Vorhersagezeitpunkt festlegen: Zu welchem Zeitpunkt muss die reale Entscheidung getroffen werden?
- Feature-Verfügbarkeit prüfen: Welche Informationen existieren zu genau diesem Zeitpunkt tatsächlich?
- Zeitfenster begrenzen: Enden Aggregationen und historische Kennzahlen spätestens am Vorhersagezeitpunkt?
- Joins kontrollieren: Werden bei Datenzusammenführungen spätere Status-, Ergebnis- oder Prozessinformationen ausgeschlossen?
- Vorverarbeitung trennen: Werden datenabhängige Transformationen ausschließlich auf Trainingsdaten gelernt?
| Situation | Problem | Prüffrage |
|---|---|---|
| Zukünftiges Ereignis | Ein Feature enthält Informationen, die erst nach dem Vorhersagezeitpunkt entstehen. | War die Information zu diesem Zeitpunkt bereits bekannt? |
| Aggregation | Ein Zeitraum enthält versehentlich spätere Daten. | Endet das Aggregationsfenster vor oder am Vorhersagezeitpunkt? |
| Datenzusammenführung | Spätere Status- oder Ergebnisinformationen werden mit historischen Fällen verbunden. | Welche Felder stammen aus nachgelagerten Prozessschritten? |
| Vorverarbeitung | Transformationen werden vor der Train-Test-Trennung auf dem Gesamtdatensatz gelernt. | Wurde jede lernende Transformation ausschließlich mit Trainingsdaten angepasst? |
| Zielnahe Variable | Ein Merkmal codiert die Zielvariable direkt oder indirekt. | Würde dieses Feature ohne Kenntnis des späteren Ergebnisses existieren? |
Einordnung Zeitliche Verfügbarkeit ist damit ein eigenes Qualitätskriterium. Ein Feature kann fachlich plausibel, statistisch stark und technisch korrekt berechnet sein – und dennoch unbrauchbar, wenn es zum realen Entscheidungszeitpunkt nicht existiert.
Auch Vorverarbeitung kann Datenleckage erzeugen
Buchaussage Die BookRix-EPUB zeigt Datenleckage nicht nur bei offensichtlichen Zukunftsfeatures. Auch eine Skalierung oder andere lernende Vorverarbeitung kann Testinformationen in das Training tragen, wenn sie vor der Aufteilung auf dem vollständigen Datensatz angepasst wird.
Die korrekte Reihenfolge ist: Transformation auf Trainingsdaten lernen, Trainingsdaten damit transformieren und dieselbe gelernte Transformation anschließend auf Testdaten anwenden. Pipelines helfen dabei, diese Trennung reproduzierbar einzuhalten.
Technischer Kontext Die BookRix-EPUB verweist hierfür auf Géron sowie auf scikit-learn-basierte Pipelines. Der technische Punkt ist enger als eine allgemeine Tool-Empfehlung: Datenabhängige Vorverarbeitung darf keine Information aus dem späteren Testbestand zum Lernen ihrer Parameter verwenden.
Sieben Prüffragen für Feature-Qualität und Leakage
Redaktionelle Synthese Aus 4.5 und 4.6 der BookRix-EPUB lässt sich folgende Prüfreihenfolge ableiten. Sie ist kein validiertes Assessment und ersetzt keine projektspezifische Feature-Analyse.
- Fachliche Relevanz: Warum sollte dieses Merkmal mit der Zielgröße oder der Entscheidung zusammenhängen?
- Datenqualität: Sind Verteilung, Kategorien, fehlende Werte und Berechnungslogik plausibel und nachvollziehbar?
- Redundanz: Liefert das Feature wirklich neue Information oder nur eine andere Darstellung bereits vorhandener Merkmale?
- Stabilität: Bleiben Bedeutung und Berechenbarkeit auch bei neuen Daten und veränderten Prozessen erhalten?
- Produktionsfähigkeit: Können die benötigten Daten im späteren Betrieb zuverlässig und automatisiert bereitgestellt werden?
- Vorhersagezeitpunkt: War jede verwendete Information zum realen Entscheidungszeitpunkt tatsächlich verfügbar?
- Train-Test-Trennung: Wurden lernende Transformationen ausschließlich auf Trainingsdaten angepasst?
Ein scheinbar außergewöhnlich starkes Feature sollte besonders kritisch geprüft werden. Unerwartet hohe Modellgüte kann ein Signal für echten Informationsgehalt sein – oder für Leakage.
Wo die Aussage bewusst endet
Die Vermeidung von Datenleckage garantiert noch kein gutes Modell. Ein leakage-freies Feature kann fachlich irrelevant, instabil, verrauscht oder redundant sein. Ebenso bedeutet eine hohe Feature-Wichtigkeit in einem bestimmten Modell nicht automatisch Kausalität oder allgemeine Bedeutung.
Diese Seite bewertet Merkmale und ihre Risiken. Die systematische Übersetzung einer Fragestellung in Zielvariable, Modellierungsaufgabe und belastbare Trainings-/Testlogik ist Gegenstand der nächsten Fachfrage.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere 4.5 „Feature-Qualität bewerten“ und 4.6 „Datenleckage und Feature-Risiken“.
Feature-Qualität Max Kuhn und Kjell Johnson (2019): Feature Engineering and Selection: A Practical Approach for Predictive Models. CRC Press; Trevor Hastie, Robert Tibshirani und Jerome Friedman (2009): The Elements of Statistical Learning: Data Mining, Inference, and Prediction. 2. Auflage, Springer.
Produktions- und Leakage-Risiken Aurélien Géron (2022): Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3. Auflage, O’Reilly Media; Chip Huyen (2022): Designing Machine Learning Systems. O’Reilly Media; D. Sculley, Gary Holt, Daniel Golovin u. a. (2015): „Hidden technical debt in Machine learning systems“; Eric Breck, Shanqing Cai, Eric Nielsen, Michael Salib und D. Sculley (2020): The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction.
Die externen Quellen werden hier nur in dem Umfang eingeordnet, in dem sie in der veröffentlichten BookRix-EPUB als fachlicher Kontext verwendet werden. Sie ersetzen keine projektspezifische Prüfung von Datenverfügbarkeit, Feature-Stabilität oder zeitlicher Kausalstruktur.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.