ZIELVARIABLE, AUFGABENTYP UND DATENTRENNUNG · FRAGE 6 VON 12
Wie wird aus einer Fragestellung eine belastbare Machine-Learning-Aufgabe?
Zwischen einer fachlichen Frage und einem trainierbaren Modell liegen mehrere Entscheidungen. Die Frage muss in eine datenbasierte Aufgabe übersetzt, eine belastbare Zielvariable definiert, der passende Aufgabentyp bestimmt und eine Trainings-/Testlogik gewählt werden, die die spätere Anwendung realistisch abbildet.
Kurzantwort: Die veröffentlichte BookRix-EPUB führt von der fachlichen Fragestellung zur Modellierungsaufgabe in mehreren Schritten: Geschäftsfrage in eine datenbasierte Frage übersetzen, Zielvariable festlegen, Klassifikation oder Regression bestimmen, verfügbare Informationen und Domänenwissen prüfen und Trainings- und Testdaten so trennen, dass die spätere Anwendung realistisch simuliert wird. Ein belastbarer Task ist damit nicht nur technisch trainierbar, sondern fachlich eindeutig und evaluierbar.
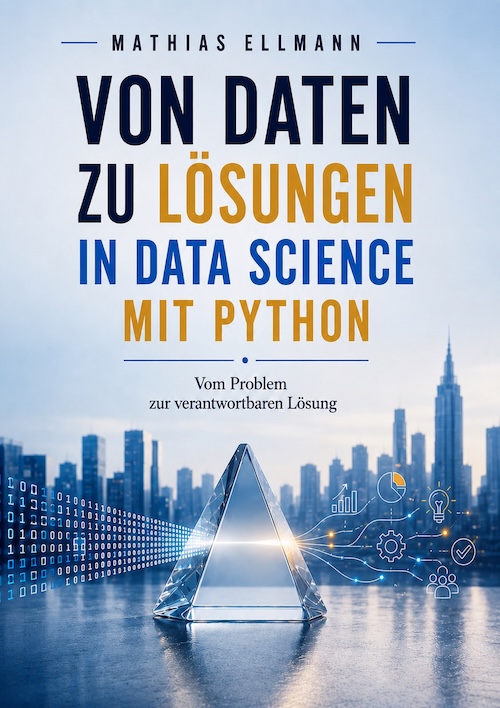
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: 5.1 „Von der Fragestellung zum Modell“ und 5.3 „Train-Test-Split im Projektkontext“.
Abschnitt 5.1 behandelt die Übersetzung von Geschäfts- zu Datenfragen, Zielvariablen, Klassifikation und Regression, verfügbare Informationen, Domänenwissen und typische Fehler beim Übergang zum Modell. Abschnitt 5.3 ergänzt die zur Anwendung passende Trennung von Trainings-, Validierungs- und Testdaten.
Aus einer Fachfrage muss zuerst eine modellierbare Datenfrage werden
Buchaussage Abschnitt 5.1 der BookRix-EPUB beginnt mit einer klaren Trennung: Ein Data-Science-Projekt startet mit einer Fragestellung, aber eine fachliche Geschäftsfrage lässt sich nicht automatisch modellieren. Die Frage „Wie können wir Kundenverluste reduzieren?“ wird im Buch deshalb zunächst in eine datenbasierte Frage übersetzt: „Welche Kunden werden wahrscheinlich in den nächsten drei Monaten kündigen?“
Erst diese Präzisierung definiert einen beobachtbaren Gegenstand, einen Zeitraum und eine Vorhersageaufgabe. Sie schafft damit die Voraussetzung dafür, Daten und Zielvariable sinnvoll festzulegen.
- Fachproblem: Welcher reale Zustand soll verstanden oder verbessert werden?
- Datenfrage: Welche konkrete Beobachtung oder Vorhersage lässt sich aus dem Problem ableiten?
- Zielvariable: Welches messbare Ergebnis bildet diese Frage ab?
- Aufgabentyp: Handelt es sich um Klassen, numerische Werte oder eine andere datenanalytische Struktur?
- Bewertungsrahmen: Welche Daten müssen zurückgehalten werden, damit die spätere Anwendung realistisch geprüft werden kann?
Einordnung Die Modellierungsaufgabe ist damit eine operationalisierte Version der ursprünglichen Fragestellung. Wird dieser Übersetzungsschritt übersprungen, kann ein technisch korrektes Modell entstehen, das fachlich am Problem vorbeigeht.
Fachlicher Kontext Die BookRix-EPUB verweist für problemorientiertes datenanalytisches Denken unter anderem auf Foster Provost und Tom Fawcett, Data Science for Business (2013), Fayyad, Piatetsky-Shapiro und Smyth (1996) sowie CRISP-DM. Im Buch unterstützen diese Referenzen die Einordnung, dass Modellierung in einen größeren Problem-, Erkenntnis- und Entscheidungsprozess eingebettet ist.
Die Zielvariable übersetzt die Frage in ein lernbares Ziel
Buchaussage Abschnitt 5.1 formuliert: Ein Modell benötigt ein klares Ziel. Dieses Ziel wird als Zielvariable bezeichnet. Beispiele des Buches sind „Kunde kündigt?“ mit Ja/Nein, eine Umsatzprognose mit einem numerischen Umsatzwert, eine Kreditrisikobewertung mit einer Risikoklasse oder eine Produktempfehlung über Kaufwahrscheinlichkeit.
Die Qualität der Zielvariable beeinflusst unmittelbar die Qualität des späteren Modells. Eine unklare, inkonsistent erzeugte oder fachlich ungeeignete Zielgröße macht auch eine technisch saubere Modellierung fragwürdig.
Einordnung Zieldefinition ist deshalb keine reine Spaltenauswahl. Es muss geklärt sein, welches Ereignis oder welcher Wert zählt, zu welchem Zeitpunkt er gemessen wird und ob er die ursprüngliche Frage tatsächlich repräsentiert.
Klassifikation oder Regression folgt aus der Art der Fragestellung
Buchaussage Abschnitt 5.1 unterscheidet zwei grundlegende Aufgabentypen. Klassifikation ordnet Beobachtungen Klassen zu, etwa Betrug oder kein Betrug, Kündigung oder keine Kündigung oder Spam oder kein Spam. Regression sagt numerische Werte wie Umsatz, Preis, Lieferzeit oder Energieverbrauch vorher.
| Fragestellung | Zielvariable | Typische Aufgabe |
|---|---|---|
| Kündigt ein Kunde? | Ja / Nein | Klassifikation |
| Wie hoch wird der Umsatz? | Umsatzwert | Regression |
| Welcher Risikoklasse gehört ein Antrag an? | Risikoklasse | Klassifikation |
| Wie lange dauert eine Lieferung? | Lieferzeit | Regression |
Einordnung Der Algorithmus bestimmt damit nicht den Aufgabentyp; die operationalisierte Fragestellung tut es. Erst wenn Ziel und Datentyp klar sind, kann sinnvoll über konkrete Modellklassen gesprochen werden.
Nicht jede sinnvolle Fragestellung ist mit vorhandenen Daten lösbar
Buchaussage Nach der Zieldefinition fordert Abschnitt 5.1 eine Prüfung der verfügbaren Informationen: Welche Datenquellen und Merkmale existieren, wie vollständig und qualitativ sind sie und stehen historische Daten zur Verfügung? Die EPUB weist ausdrücklich darauf hin, dass nicht jede Fragestellung mit den vorhandenen Daten lösbar ist.
Domänenwissen ergänzt diese Prüfung. Daten allein erklären selten den gesamten Kontext. Fachwissen hilft, relevante Merkmale zu identifizieren, unrealistische Annahmen zu erkennen und die Modellierungsaufgabe mit dem realen Prozess abzugleichen.
Einordnung Eine belastbare ML-Aufgabe enthält daher auch eine Machbarkeitsaussage: Es muss genügend geeignete Information geben, um das definierte Ziel unter realistischen Bedingungen überhaupt lernen und später erzeugen zu können.
Der Train-Test-Split muss die spätere Anwendung abbilden
Buchaussage Abschnitt 5.3 begründet die Trennung von Trainings- und Testdaten damit, dass ein Modell nicht nur bekannte Beispiele erklären, sondern bei neuen, bisher unbekannten Daten funktionieren soll. Wird auf denselben Daten trainiert und bewertet, entsteht ein verzerrtes Bild der Leistungsfähigkeit.
Der Split ist kein rein technischer Standardschritt. Er muss zur Fragestellung passen. Bei zufällig verteilten Kundendaten kann eine zufällige Aufteilung sinnvoll sein; bei zeitabhängigen Daten ist häufig eine zeitliche Trennung erforderlich. Bei unausgewogenen Klassen kann eine stratifizierte Aufteilung helfen, seltene Zielereignisse angemessen abzubilden.
Training, Validierung und Test erfüllen dabei unterschiedliche Rollen: Trainingsdaten dienen dem Lernen; Validierungsdaten oder geeignete interne Resampling-Verfahren unterstützen Entwicklungsentscheidungen; der Testbestand soll eine möglichst unabhängige abschließende Prüfung ermöglichen. Wird der Testbestand wiederholt zur Feature-, Modell- oder Parameterwahl betrachtet, verliert er diese Unabhängigkeit.
Einordnung Die Datentrennung ist damit Teil der Aufgabenformulierung. Sie definiert nicht nur, was „unbekannte Daten“ bedeuten, sondern auch, welche Daten für welche Entwicklungsentscheidung verwendet werden dürfen.
Technischer Kontext Die BookRix-EPUB verweist für Train-Test-Splits und Modellbewertung unter anderem auf Aurélien Géron (2022) sowie Hastie, Tibshirani und Friedman (2009). Scikit-learn stellt technische Hilfsmittel für Splits, Stratifizierung und Pipelines bereit; die fachliche Entscheidung über eine zur Anwendung passende Trennung bleibt projektspezifisch.
Beispiel: Aus „Rücksendungen reduzieren“ wird eine Klassifikationsaufgabe
Buchbeispiel Abschnitt 5.1 verwendet einen Online-Händler, der Rücksendungen reduzieren möchte. Die ursprüngliche Frage „Wie können wir die Zahl der Rücksendungen senken?“ wird zur Modellierungsfrage „Welche Bestellungen werden mit hoher Wahrscheinlichkeit zurückgesendet?“
Als mögliche Merkmale nennt das Buch Produktkategorie, Preis, Kundengruppe, Lieferzeit und bisheriges Kaufverhalten. Die Zielvariable lautet Rücksendung = Ja oder Nein. Damit entsteht eine Klassifikationsaufgabe.
Einordnung Das Modell beantwortet nicht direkt die strategische Frage, wie Rücksendungen reduziert werden. Es liefert eine Vorhersage, die anschließend in eine konkrete Entscheidung oder Maßnahme eingebettet werden muss.
Sieben Prüffragen für eine belastbare Machine-Learning-Aufgabe
Redaktionelle Synthese Aus 5.1 und 5.3 der BookRix-EPUB lässt sich folgende Prüfreihenfolge ableiten. Sie ersetzt weder fachliche Projektklärung noch eine spätere Modell- und Metrikbewertung.
- Problembezug: Welches reale Problem oder welche Entscheidung soll die ML-Aufgabe unterstützen?
- Datenfrage: Ist die fachliche Frage in eine konkrete, beobachtbare oder vorhersagbare Datenfrage übersetzt?
- Zielvariable: Ist eindeutig definiert, was vorhergesagt wird und wie dieses Ziel erzeugt wird?
- Aufgabentyp: Passt Klassifikation, Regression oder ein anderer Ansatz zur Zielvariable?
- Informationslage: Sind die benötigten Merkmale in ausreichender Qualität und zum späteren Einsatzzeitpunkt verfügbar?
- Datentrennung: Bildet der Train-Test-Split die spätere Anwendung realistisch ab, etwa zeitlich oder stratifiziert?
- Unabhängige Bewertung: Bleibt der Testdatensatz bis zur finalen Bewertung unabhängig von Modell- und Transformationsentscheidungen?
Wenn diese Punkte nicht klar beantwortet werden können, ist häufig noch nicht der Algorithmus das Problem, sondern die Aufgabenformulierung.
Wo die Aussage bewusst endet
Eine sauber formulierte Machine-Learning-Aufgabe garantiert noch kein gutes Modell. Zielvariable und Datentrennung können korrekt sein, während Datenqualität, Features, Modellwahl oder Metriken ungeeignet bleiben.
Diese Seite behandelt bewusst noch nicht, welches konkrete Modell die beste Alternative darstellt, wie eine Baseline gewählt oder wie Hyperparameter systematisch verglichen werden. Diese Entscheidungen gehören zur nächsten Fachfrage.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere 5.1 „Von der Fragestellung zum Modell“ und 5.3 „Train-Test-Split im Projektkontext“.
Problem- und Entscheidungsbezug Foster Provost und Tom Fawcett (2013): Data Science for Business. O’Reilly Media; Usama Fayyad, Gregory Piatetsky-Shapiro und Padhraic Smyth (1996): „From Data Mining to Knowledge Discovery in Databases“; Pete Chapman, Julian Clinton, Randy Kerber u. a. (2000): CRISP-DM 1.0.
Modellierung und Datentrennung Trevor Hastie, Robert Tibshirani und Jerome Friedman (2009): The Elements of Statistical Learning. 2. Auflage, Springer; Aurélien Géron (2022): Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3. Auflage, O’Reilly Media; Fabian Pedregosa, Gaël Varoquaux, Alexandre Gramfort u. a. (2011): „Scikit-learn: Machine Learning in Python“.
Die externen Quellen werden hier nur in dem Umfang eingeordnet, in dem sie in der veröffentlichten BookRix-EPUB als fachlicher oder technischer Kontext verwendet werden. Die konkrete Definition einer Zielvariable und die Wahl einer Datentrennung müssen immer zum jeweiligen Projektkontext passen.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.