METRIKEN, FEHLERARTEN UND ENTSCHEIDUNGSSCHWELLEN · FRAGE 8 VON 12
Wie wählt man passende Metriken, Schwellenwerte und Fehlerkosten?
Eine Modellkennzahl ist nur dann nützlich, wenn klar ist, welche Eigenschaft des Modells sie beschreibt und welche Fehler im realen Einsatz relevant sind. Accuracy, Precision, Recall, F1 oder ROC-AUC beantworten unterschiedliche Fragen. Entscheidungsschwellen verbinden anschließend Modellwahrscheinlichkeiten mit konkreten Handlungen und deren Fehlerfolgen.
Kurzantwort: Die veröffentlichte BookRix-EPUB behandelt Metriken als Entscheidungshilfen, nicht als Selbstzweck. Accuracy kann bei unausgewogenen Klassen täuschen; Confusion Matrix, Precision, Recall und F1 machen unterschiedliche Fehlerarten sichtbar. Viele Klassifikationsmodelle liefern zudem Wahrscheinlichkeiten, aus denen erst durch einen Schwellenwert eine Handlung entsteht. Der passende Schwellenwert hängt deshalb nicht automatisch bei 0,5, sondern vom Projektziel und von den Folgen von False Positives und False Negatives ab.
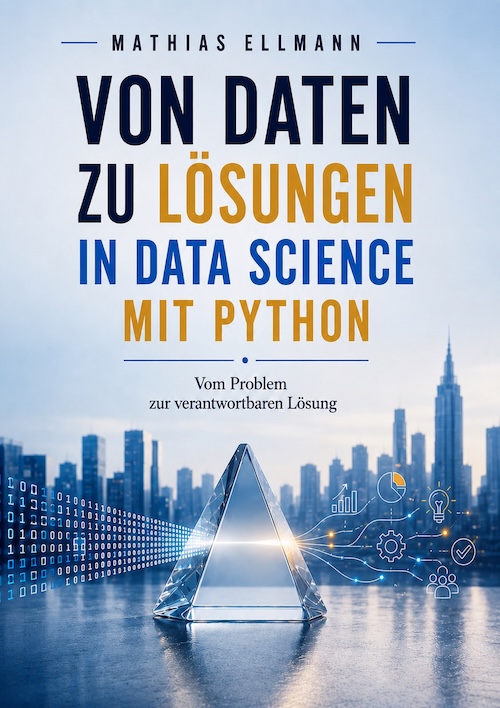
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: 6.1 „Metriken als Entscheidungshilfen“, 6.2 „Confusion Matrix im Problemkontext“, 6.3 „Precision, Recall und F1 begründen“ sowie 6.4 „ROC-AUC und Schwellenwerte“.
Diese Abschnitte verbinden Modellkennzahlen mit Projektzielen, Fehlerarten und konkreten Entscheidungen. Sie behandeln unter anderem Accuracy bei unausgewogenen Klassen, False Positives und False Negatives, Precision, Recall, F1, ROC-AUC, Vorhersagewahrscheinlichkeiten, Entscheidungsschwellen sowie die fachlichen Kosten unterschiedlicher Fehlentscheidungen.
Metriken sind Entscheidungshilfen – keine Ziele an sich
Buchaussage Abschnitt 6.1 der BookRix-EPUB beschreibt Metriken als Grundlage einer systematischen Modellbewertung. Sie helfen, Modellvarianten zu vergleichen, Fehler sichtbar zu machen und Entscheidungen nachvollziehbar zu begründen. Gleichzeitig warnt das Buch davor, eine einzelne Kennzahl zum eigentlichen Projektziel zu machen.
Unterschiedliche Metriken beantworten unterschiedliche Fragen. Eine geeignete Kennzahl muss deshalb zum Projektziel passen. Für Klassifikation und Regression werden unterschiedliche Bewertungsgrößen benötigt; selbst innerhalb einer Klassifikationsaufgabe können verschiedene Fehlerarten unterschiedlich relevant sein.
Einordnung Ein Score ist damit keine vollständige Aussage über Modellqualität. Er verdichtet einen bestimmten Aspekt. Die fachliche Bewertung beginnt erst mit der Frage, ob genau dieser Aspekt für die spätere Entscheidung relevant ist.
Fachlicher Kontext Die BookRix-EPUB verweist bei der Einordnung von Metriken unter anderem auf Foster Provost und Tom Fawcett, Data Science for Business (2013), sowie auf Hastie, Tibshirani und Friedman, The Elements of Statistical Learning (2009). Im Buch stützen diese Referenzen die Sicht, dass Bewertungskennzahlen immer im Kontext von Problem, Fehlerarten und Entscheidungsziel interpretiert werden müssen.
Warum Accuracy allein häufig nicht genügt
Buchaussage Abschnitt 6.1 zeigt die Grenzen von Accuracy besonders bei unausgewogenen Klassen. Sind beispielsweise nur ein Prozent aller Transaktionen Betrugsfälle, erreicht ein Modell, das immer „kein Betrug“ vorhersagt, bereits 99 Prozent Accuracy – obwohl es keinen einzigen Betrugsfall erkennt.
Eine hohe Gesamtquote korrekter Vorhersagen kann damit genau die Fälle verdecken, die fachlich besonders wichtig sind.
- Projektziel: Welche Entscheidung soll die Modellbewertung unterstützen?
- Klassenverteilung: Sind positive und negative Fälle annähernd gleich häufig oder stark unausgewogen?
- Fehlerarten: Welche Folgen haben False Positives und False Negatives?
- Maßnahme: Welche reale Aktion wird durch eine positive oder negative Vorhersage ausgelöst?
- Metrikmix: Welche Kennzahlen müssen gemeinsam betrachtet werden, damit diese Folgen sichtbar bleiben?
Einordnung Accuracy kann weiterhin nützlich sein. Problematisch wird sie dann, wenn sie ohne Klassenverteilung und Fehlerstruktur als alleiniger Qualitätsnachweis verwendet wird.
Die Confusion Matrix macht Fehlerarten und Fehlerkosten sichtbar
Buchaussage Abschnitt 6.2 stellt die Confusion Matrix in den Problemkontext. Sie unterscheidet True Positives, True Negatives, False Positives und False Negatives. Gerade die beiden Fehlerarten sind fachlich wichtig, weil ihre Folgen häufig unterschiedlich schwer wiegen.
Bei einer Kündigungsvorhersage kann ein False Positive bedeuten, dass ein Kunde unnötig kontaktiert wird. Ein False Negative kann bedeuten, dass ein tatsächlich abwanderungsgefährdeter Kunde nicht erkannt wird. Welche Fehlerart kritischer ist, hängt von Projektziel, Maßnahme und Kosten ab.
| Ergebnis | Bedeutung | Fachliche Anschlussfrage |
|---|---|---|
| True Positive | Positiver Fall wird korrekt erkannt. | Welchen Nutzen erzeugt die richtige Erkennung? |
| False Positive | Ein negativer Fall wird fälschlich als positiv markiert. | Welche Kosten oder Belastungen erzeugt der Fehlalarm? |
| False Negative | Ein positiver Fall wird übersehen. | Welche Folgen entstehen, wenn der relevante Fall unentdeckt bleibt? |
| True Negative | Negativer Fall wird korrekt nicht ausgelöst. | Welche unnötigen Maßnahmen werden dadurch vermieden? |
Einordnung Fehlerkosten müssen nicht ausschließlich monetär sein. Sie können auch Arbeitsaufwand, verpasste Chancen, Kundenbelastung oder andere fachliche Konsequenzen umfassen. Entscheidend ist, dass sie für die Entscheidung explizit gemacht werden.
Precision, Recall und F1 beantworten unterschiedliche Fragen
Buchaussage Abschnitt 6.3 grenzt Precision und Recall über unterschiedliche Fehlerperspektiven ab. Precision fragt, wie zuverlässig positive Vorhersagen sind. Recall fragt, wie viele der tatsächlich positiven Fälle erkannt wurden.
Precision ist besonders relevant, wenn positive Vorhersagen konkrete Kosten oder Eingriffe auslösen und Fehlalarme vermieden werden sollen. Recall gewinnt an Bedeutung, wenn übersehene positive Fälle besonders schwerwiegende Folgen haben. Zwischen beiden Größen besteht häufig ein Zielkonflikt.
Der F1-Score verbindet Precision und Recall als harmonisches Mittel. Das Buch betont jedoch seine Grenze: F1 behandelt beide Perspektiven gleich. Wenn im Projekt eine Fehlerart deutlich schwerer wiegt, darf F1 nicht automatisch die entscheidende Kennzahl sein.
Einordnung Die Metrikwahl ist somit bereits eine implizite Gewichtung von Fehlerfolgen. Sie sollte ausdrücklich begründet und dokumentiert werden.
Der Schwellenwert verbindet Wahrscheinlichkeit und Handlung
Buchaussage Die Abschnitte 6.2 bis 6.4 zeigen, dass viele Klassifikationsmodelle Wahrscheinlichkeiten liefern. Erst ein Schwellenwert legt fest, ab welchem Wert ein Fall als positiv klassifiziert wird. Der häufig verwendete Standard von 0,5 ist bequem, aber nicht automatisch fachlich richtig.
Ein niedrigerer Schwellenwert erhöht häufig den Recall und erkennt mehr positive Fälle, erzeugt aber typischerweise mehr False Positives. Ein höherer Schwellenwert kann die Precision erhöhen, übersieht dafür möglicherweise mehr tatsächlich positive Fälle.
Einordnung Damit ist die Schwellenwertwahl keine nachträgliche technische Feinjustierung. Sie bestimmt unmittelbar, welche Fälle eine reale Maßnahme auslösen und welche Fehlerfolgen akzeptiert werden.
Buchkontext Die BookRix-EPUB verwendet unter anderem Kundenabwanderung und Betrugserkennung, um die Wirkung unterschiedlicher Schwellenwerte zu verdeutlichen. Bei Betrug können übersehene Fälle besonders teuer sein; bei sehr vielen Fehlalarmen können zugleich Prüfteams überlastet werden. Der geeignete Schwellenwert muss deshalb an die tatsächliche Umsetzung gekoppelt werden.
ROC-AUC bewertet Trennfähigkeit, ersetzt aber keinen Entscheidungsschwellenwert
Buchaussage Abschnitt 6.4 beschreibt die ROC-Kurve als Darstellung des Modellverhaltens über unterschiedliche Schwellenwerte hinweg. Die AUC fasst diese Kurve in einer Zahl zusammen und kann helfen, die grundsätzliche Trennfähigkeit verschiedener Modelle zu vergleichen.
Die EPUB warnt jedoch davor, ROC-AUC isoliert zu verwenden. Bei stark unausgewogenen Klassen kann die Kennzahl zu optimistisch wirken; ergänzende Perspektiven wie Precision, Recall oder Precision-Recall-Darstellungen können dann wichtiger sein.
Einordnung Eine gute Trennfähigkeit beantwortet noch nicht, bei welchem Schwellenwert eine konkrete Handlung ausgelöst werden sollte. Modellvergleich und Entscheidungsschwelle sind zwei verschiedene Fragen.
Sieben Prüffragen für Metriken, Schwellenwerte und Fehlerkosten
Redaktionelle Synthese Aus den Abschnitten 6.1 bis 6.4 der BookRix-EPUB lässt sich folgende Prüfreihenfolge ableiten. Sie ersetzt keine projektspezifische Kostenrechnung und nimmt die umfassendere Risiko- und Unsicherheitsbewertung der nächsten Wissensseite nicht vorweg.
- Projektziel: Welche reale Entscheidung soll die Kennzahl unterstützen?
- Fehlerarten: Welche Bedeutung haben False Positives und False Negatives im konkreten Prozess?
- Fehlerkosten: Welche fachlichen, wirtschaftlichen oder operativen Folgen haben diese Fehler?
- Metriken: Welche Kombination aus Accuracy, Precision, Recall, F1 oder weiteren Kennzahlen macht diese Folgen sichtbar?
- Wahrscheinlichkeit: Liefert das Modell Scores oder Wahrscheinlichkeiten, die vor einer harten Entscheidung betrachtet werden sollten?
- Schwellenwert: Welcher Wert übersetzt Modelloutput in eine zur Fehlerstruktur passende Handlung?
- Überprüfung: Werden Metriken und Schwellenwert dokumentiert und bei veränderten Daten, Prozessen oder Kosten erneut geprüft?
Die beste Kennzahl oder Schwelle ist damit nicht abstrakt die mit dem höchsten Score, sondern diejenige, die zur konkreten Entscheidungssituation passt.
Wo die Aussage bewusst endet
Passende Metriken und ein begründeter Schwellenwert garantieren noch keine gute Gesamtlösung. Ein Modell kann bei einer gewählten Kennzahl überzeugen und dennoch zu komplex, schwer interpretierbar, instabil oder im Betrieb riskant sein.
Diese Seite behandelt deshalb bewusst noch nicht den vollständigen Vergleich solcher Zielkonflikte, die verbleibende Unsicherheit von Modellergebnissen oder technische, ethische und betriebliche Risiken. Diese Fragen gehören zur nächsten Fachfrage.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere 6.1 bis 6.4.
Metriken und Modellbewertung Foster Provost und Tom Fawcett (2013): Data Science for Business. O’Reilly Media; Trevor Hastie, Robert Tibshirani und Jerome Friedman (2009): The Elements of Statistical Learning. 2. Auflage, Springer. Beide werden in der BookRix-EPUB im Kontext von Metriken, Precision, Recall und Modellbewertung herangezogen.
Redaktionelle Einordnung Confusion Matrix, Precision, Recall, F1, ROC-AUC und Schwellenwerte werden hier nicht als allgemeine Rangliste behandelt. Ihre Bedeutung ergibt sich aus Projektziel, Klassenverteilung, Fehlerfolgen und der realen Handlung, die ein Modelloutput auslöst.
Die externen Quellen werden ausschließlich in dem Umfang eingeordnet, in dem sie in der veröffentlichten BookRix-EPUB als fachlicher Kontext verwendet werden. Die konkrete Bewertung von Fehlerkosten und Entscheidungsschwellen bleibt projektspezifisch.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.