DATENQUELLEN, HERKUNFT UND QUALITÄT · FRAGE 2 VON 12
Wie beurteilt man Datenquellen und Datenqualität in Data-Science-Projekten?
Datenqualität beginnt nicht erst bei fehlenden Werten oder Ausreißern. Wer belastbare Analysen und Modelle entwickeln will, muss zunächst verstehen, woher Daten stammen, wie sie entstanden sind, welche Entscheidungen ihre Erfassung geprägt haben und ob sie für die konkrete Fragestellung geeignet sind.
Kurzantwort: Gute Datenqualität lässt sich nicht auf eine einzelne Kennzahl reduzieren. Die veröffentlichte BookRix-EPUB betrachtet Daten als Ergebnis konkreter Entstehungsprozesse. Herkunft, Erhebungsmethode, Dokumentation, Vollständigkeit, Genauigkeit, Konsistenz, Aktualität, Eindeutigkeit und Relevanz müssen deshalb gemeinsam beurteilt werden. Auffälligkeiten wie fehlende Werte, Dubletten oder Ausreißer sind zunächst Diagnosehinweise – nicht automatisch Fehler.
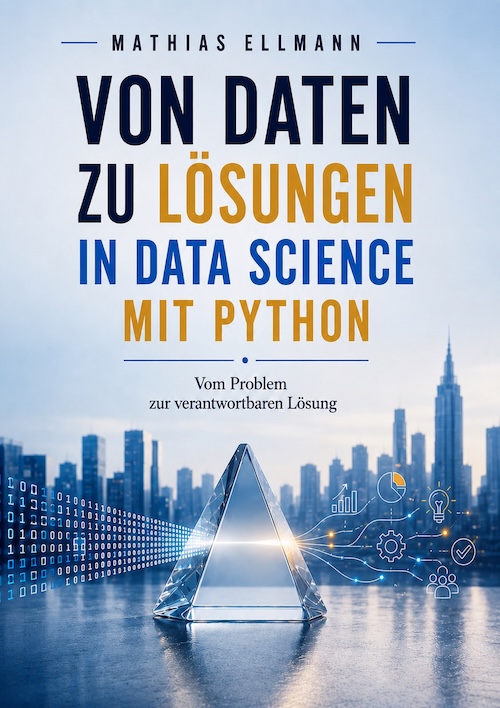
DIESE WISSENSSEITE GEHÖRT ZUM BUCH
Von Daten zu Lösungen in Data Science mit Python
Vom Problem zur verantwortbaren Lösung
Besonders relevante Stellen der veröffentlichten BookRix-EPUB: Kapitel 2 „Daten beschaffen und verstehen“, insbesondere 2.1 „Datenquellen und Datenherkunft“, 2.2 „Rohdaten als Ausgangspunkt“, 2.3 „Datenqualität diagnostizieren“ und 2.4 „Fehlende Werte, Dubletten und Ausreißer“.
Dort wird Datenqualität nicht als nachträgliche Bereinigung verstanden. Die Herkunft der Daten, ihr Entstehungsprozess, bekannte Einschränkungen und die Eignung für die konkrete Fragestellung gehören bereits zur Qualitätsbeurteilung.
Datenherkunft ist bereits ein Qualitätsmerkmal
Buchaussage Abschnitt 2.1 der BookRix-EPUB beginnt mit einer grundlegenden Frage: Woher stammen die Daten eigentlich? Die Herkunft beeinflusst Qualität, Aussagekraft und Eignung für eine Fragestellung. Wer Daten verwendet, ohne ihren Ursprung zu verstehen, riskiert Fehlinterpretationen und daraus folgende Fehlentscheidungen.
Daten entstehen durch Prozesse, Systeme, Menschen und technische Messverfahren. Webformulare, Sensoren, ERP-Systeme, Anwendungen oder externe Anbieter erzeugen Daten jeweils unter anderen Bedingungen. Jeder dieser Prozesse kann Lücken, Verzerrungen, Messfehler oder uneinheitliche Bedeutungen erzeugen.
Einordnung Deshalb beginnt Qualitätsprüfung nicht erst mit isna(), Dubletten oder statistischen Ausreißern. Vor jeder technischen Diagnose steht die Frage, was ein Datensatz überhaupt repräsentiert und unter welchen Bedingungen seine Werte entstanden sind.
Fachlicher Kontext Die BookRix-EPUB verweist im Abschnitt zur Datenqualitätsdiagnose auf Jack E. Olson: Data Quality: The Accuracy Dimension (2003). Im Buch wird diese Referenz dafür herangezogen, Datenqualität als Diagnoseaufgabe zu behandeln: Auffälligkeiten sollen früh erkannt, Ursachen untersucht und geeignete Maßnahmen daraus abgeleitet werden.
Welche Datenquelle passt zur Fragestellung?
Buchaussage Abschnitt 2.1 unterscheidet interne und externe sowie Primär- und Sekundärdaten. Interne Quellen wie ERP-, CRM-, Produktions-, Log-, Finanz- oder Supportsysteme sind eng mit realen Geschäftsprozessen verbunden, wurden aber häufig nicht für analytische Zwecke erhoben. Externe Quellen können zusätzliche Perspektiven eröffnen, bringen jedoch unter anderem unbekannte Erhebungsmethoden, unterschiedliche Aktualität sowie rechtliche und lizenzbezogene Einschränkungen mit.
- Zweck: Für welchen ursprünglichen Zweck wurden die Daten erhoben?
- Erzeugung: Wer oder welches System erzeugt die Daten?
- Aktualisierung: Wann und wie häufig werden Werte verändert oder ergänzt?
- Bedeutung: Welche fachliche Bedeutung besitzen Felder und Kategorien?
- Einschränkungen: Welche bekannten Lücken, Qualitätsprobleme oder Nutzungsgrenzen existieren?
Einordnung Besonders bei Sekundärdaten entsteht ein Passungsproblem: Ein Datensatz kann technisch sauber und dennoch für die aktuelle Fragestellung ungeeignet sein, weil er ursprünglich für einen anderen Zweck erhoben wurde. Qualität ist deshalb immer auch Zweck- und Kontextqualität.
Rohdaten sind Spuren ihres Entstehungsprozesses
Buchaussage Abschnitt 2.2 beschreibt Rohdaten als ursprünglich erfasste Informationen, die noch nicht gezielt für analytische Zwecke bereinigt oder vereinheitlicht wurden. Gerade Fehler, Lücken, Mehrdeutigkeiten und Inkonsistenzen machen sie für die Diagnose wertvoll, weil sie Hinweise auf die reale Datenerfassung geben.
Fehlende Angaben können auf schlecht gestaltete Eingabemasken oder technische Störungen hinweisen. Unterschiedliche Schreibweisen können aus heterogenen Systemen stammen. Ungewöhnliche Messwerte können Erfassungsfehler sein – oder ein seltenes reales Ereignis. Die BookRix-EPUB warnt deshalb davor, Auffälligkeiten automatisch als Fehler zu behandeln.
Einordnung Eine Datenbereinigung, die den Entstehungskontext ignoriert, kann Information vernichten. Die fachliche Frage lautet nicht nur „Ist dieser Wert ungewöhnlich?“, sondern auch „Welche reale oder technische Ursache kann dieses Muster erklären?“
Datenqualität ist mehrdimensional
Buchaussage Abschnitt 2.3 nennt sechs häufige Qualitätsdimensionen: Vollständigkeit, Genauigkeit, Konsistenz, Aktualität, Eindeutigkeit und Relevanz. Keine dieser Dimensionen allein beschreibt die Qualität eines Datensatzes vollständig.
| Dimension | Prüffrage | Typisches Risiko |
|---|---|---|
| Vollständigkeit | Fehlen für die Aufgabe wichtige Werte oder Fälle? | Bestimmte Gruppen oder Situationen werden unzureichend abgebildet. |
| Genauigkeit | Entsprechen Werte dem tatsächlich gemeinten Sachverhalt? | Mess-, Erfassungs- oder Übertragungsfehler verfälschen Ergebnisse. |
| Konsistenz | Passen Werte und Definitionen innerhalb und zwischen Feldern zusammen? | Formal gültige Angaben widersprechen sich fachlich. |
| Aktualität | Sind die Daten für die Entscheidung noch zeitlich relevant? | Veraltete Zustände werden wie aktuelle Informationen behandelt. |
| Eindeutigkeit | Ist klar, ob Datensätze reale Einheiten oder Ereignisse mehrfach repräsentieren? | Dubletten verändern Häufigkeiten und Gewichtungen. |
| Relevanz | Tragen die Daten tatsächlich zur konkreten Fragestellung bei? | Technisch verfügbare Daten lenken vom eigentlichen Problem ab. |
Einordnung Ein vollständiger Datensatz kann veraltet sein; aktuelle Daten können fehlerhaft sein; konsistente Daten können für die Zielentscheidung irrelevant sein. Datenqualität muss deshalb immer im Zusammenhang mit Projektziel und Nutzung beurteilt werden.
Beispiel: Fehlende Einkommensangaben sind nicht nur leere Zellen
Buchbeispiel Die BookRix-EPUB verwendet fehlende Einkommensangaben als Beispiel dafür, dass fehlende Werte systematisch auftreten können. Wenn bestimmte Kundengruppen ihr Einkommen besonders häufig nicht angeben, kann das Fehlen selbst Information über Erhebungsprozess oder Population enthalten.
Abschnitt 2.4 nennt als Ursachen fehlender Werte unter anderem technische Fehler, unvollständige oder freiwillige Eingaben, Datenverluste bei Importen und tatsächlich nicht verfügbare Informationen. Die passende Behandlung hängt deshalb von der Ursache und der Fragestellung ab.
Dasselbe Prinzip gilt für Dubletten und Ausreißer. Eine scheinbare Dublette kann ein legitimes Mehrfachereignis sein. Ein extremer Umsatz kann ein Eingabefehler sein – oder einen besonders wichtigen Kunden repräsentieren. Vor Löschen, Ersetzen oder Begrenzen steht daher die fachliche Diagnose.
Was Python prüfen kann – und was Kontextwissen leisten muss
Technischer Kontext Die BookRix-EPUB verwendet pandas für erste Qualitätsprüfungen: fehlende Werte zählen, Datentypen und Verteilungen prüfen, Dubletten erkennen sowie auffällige Werte sichtbar machen. Mit wenigen Befehlen lässt sich dadurch schnell feststellen, wo genauer untersucht werden sollte.
Python kann jedoch nur Regeln ausführen, die fachlich definiert wurden. Ob ein Alter von 151 Jahren unmöglich ist, ob zwei Datensätze echte Dubletten darstellen oder ob eine Kombination wie „Land = Deutschland“ und „Währung = US-Dollar“ plausibel ist, verlangt Kontextwissen und eine begründete Regel.
Werkzeug- und Betriebskontext Für Datenbearbeitung verweist die BookRix-EPUB unter anderem auf Wes McKinney, Python for Data Analysis (3. Auflage, 2022). Für kontinuierliche Qualitätsprüfungen und produktive Systeme werden außerdem Mark Treveil u. a., Introducing MLOps (2020), sowie Chip Huyen, Designing Machine Learning Systems (2022), herangezogen. Im Buch stützen diese Quellen die Einordnung, dass Datenqualität nicht einmalig hergestellt wird, sondern auch im laufenden Betrieb überwacht werden muss.
Sieben Prüffragen vor der Nutzung einer Datenquelle
Redaktionelle Synthese Aus den Abschnitten 2.1 bis 2.4 der BookRix-EPUB lässt sich eine kompakte Prüfreihenfolge ableiten. Sie ist kein validiertes Assessment und ersetzt keine projektspezifische Datenqualitätsanalyse.
- Herkunft: Woher stammen die Daten und wie wurden sie erzeugt?
- Zweck: Für welchen ursprünglichen Zweck wurden sie erhoben?
- Abdeckung: Welche relevanten Fälle, Gruppen oder Zeiträume fehlen möglicherweise?
- Entstehungsfehler: Welche manuellen, technischen oder organisatorischen Prozesse können Fehler erzeugen?
- Auffälligkeiten: Sind fehlende Werte, Dubletten oder Ausreißer zufällig, systematisch oder fachlich erklärbar?
- Passung: Sind Aktualität, Genauigkeit und Detailgrad für die konkrete Fragestellung ausreichend?
- Dokumentation: Sind Definitionen, bekannte Einschränkungen und getroffene Bereinigungsentscheidungen nachvollziehbar festgehalten?
Wenn diese Fragen unbeantwortet bleiben, ist eine zusätzliche Modelloptimierung möglicherweise weniger wertvoll als eine bessere Untersuchung der Datengrundlage.
Wo die Aussage bewusst endet
Datenherkunft und Qualitätsdiagnose garantieren noch keine unverzerrten oder für jede Entscheidung geeigneten Daten. Auch ein gut dokumentierter Datensatz kann bestimmte Populationen unzureichend abbilden, historische Prozesse reproduzieren oder für eine neue Nutzung ungeeignet sein.
Ebenso folgt aus der BookRix-EPUB nicht, dass jeder fehlende Wert ersetzt, jede Dublette gelöscht oder jeder Ausreißer entfernt werden sollte. Die begrenzte Aussage lautet: Auffälligkeiten müssen erkannt, im Entstehungskontext verstanden und im Hinblick auf die konkrete Fragestellung begründet behandelt werden.
Quellen und Einordnung
Buchgrundlage Mathias Ellmann: Von Daten zu Lösungen in Data Science mit Python. Vom Problem zur verantwortbaren Lösung. Veröffentlichte BookRix-EPUB; hier insbesondere Kapitel 2 und die Abschnitte 2.1 bis 2.4.
Datenqualität Jack E. Olson (2003): Data Quality: The Accuracy Dimension. Morgan Kaufmann. In der BookRix-EPUB im Kontext der Datenqualitätsdiagnose verwendet.
Datenbearbeitung Wes McKinney (2022): Python for Data Analysis: Data Wrangling with pandas, NumPy, and Jupyter. 3. Auflage, O’Reilly Media.
Produktive Systeme Mark Treveil, Nicolas Omont, Clément Stenac u. a. (2020): Introducing MLOps. O’Reilly Media; Chip Huyen (2022): Designing Machine Learning Systems: An Iterative Process for Production-Ready Applications. O’Reilly Media.
Die externen Quellen werden hier ausschließlich in dem Umfang eingeordnet, in dem sie in der BookRix-EPUB als fachlicher Kontext verwendet werden. Sie ersetzen weder die konkrete Prüfung einer Datenquelle noch eine projektspezifische Qualitätsbewertung.
Vom Problem zur verantwortbaren Lösung
Das Buch verfolgt den gesamten Projektweg weiter: Daten beschaffen und verstehen, aufbereiten und transformieren, Features entwickeln, Modelle erstellen und bewerten, Lösungen produktiv betreiben und Ergebnisse nachvollziehbar kommunizieren.
Mathias Ellmann
Ing. Mathias Ellmann, M. Sc. arbeitet freiberuflich als IT-Sachverständiger, KI-Berater, Trainer, Autor und Dozent. Seine Arbeit verbindet technische, didaktische, ethische, unternehmerische und gesellschaftliche Fragestellungen.